Die Google Search Console richtig nutzen: Filter, Indexierung und die Zahlen, die täuschen
Die durchschnittliche Position ist ein Mittelwert aus lauter Bestwerten, und bei zwei Statusgründen im Indexierungsbericht rät Google ausdrücklich davon ab, etwas zu tun. Dieser Leitfaden zeigt die Handgriffe, die wirklich etwas ergeben, mit Googles eigenen Formulierungen.
Datum
Kategorie
Autor
„Ich melde mich alle paar Wochen in der Search Console an, schaue auf die Kurve und mache dann nichts. Was soll ich da eigentlich tun?" Die Frage kam vom Geschäftsführer eines Elektrobetriebs, der das Werkzeug seit Jahren freigeschaltet hat. Er macht nichts falsch. Er sieht nur die eine Ansicht, die am wenigsten hergibt.
Die Search Console ist kein Besucherzähler, sondern die einzige Stelle, an der Google euch zeigt, mit welchen Suchanfragen ihr gefunden werdet und welche Seiten davon gar nicht erst im Index stehen. Beides steht nicht auf der Startseite des Werkzeugs, sondern zwei Klicks tiefer.
Dieser Beitrag geht die Stellen durch, an denen wirklich etwas zu holen ist, in der Reihenfolge, in der man sie im Betrieb braucht. Kein Grundlagenkurs: Wir setzen voraus, dass ihr das Konto habt. Alle Angaben stammen aus Googles eigener Dokumentation, Abruf 28. September 2026.
Kurz gesagt (Stand September 2026)
Seht als Erstes nach, ob eure Property die ganze Website abdeckt. Eine URL-Präfix-Property umfasst genau ein Protokoll und genau eine Subdomain, eine Domain-Property dagegen „alle Subdomains (m, www usw.) sowie mehrere Protokolle (http, https, ftp)". Wer seine Property vor dem Umstieg auf https angelegt hat, wertet seitdem einen Ausschnitt aus und weiß es nicht. Der Umbau dauert zehn Minuten und ist die Voraussetzung dafür, dass alles Weitere in diesem Beitrag überhaupt stimmt.
Domain-Property oder URL-Präfix: der Fehler, der die halbe Website unsichtbar macht
Legt eine Domain-Property an, nicht eine URL-Präfix-Property. Der Unterschied klingt nach Kleinkram und entscheidet darüber, wie viel ihr überhaupt seht. Google beschreibt die Domain-Property als „eine Property auf Domainebene, die alle Subdomains (m, www usw.) sowie mehrere Protokolle (http, https, ftp) enthält". Eine URL-Präfix-Property deckt dagegen genau ein Protokoll und genau eine Subdomain ab.
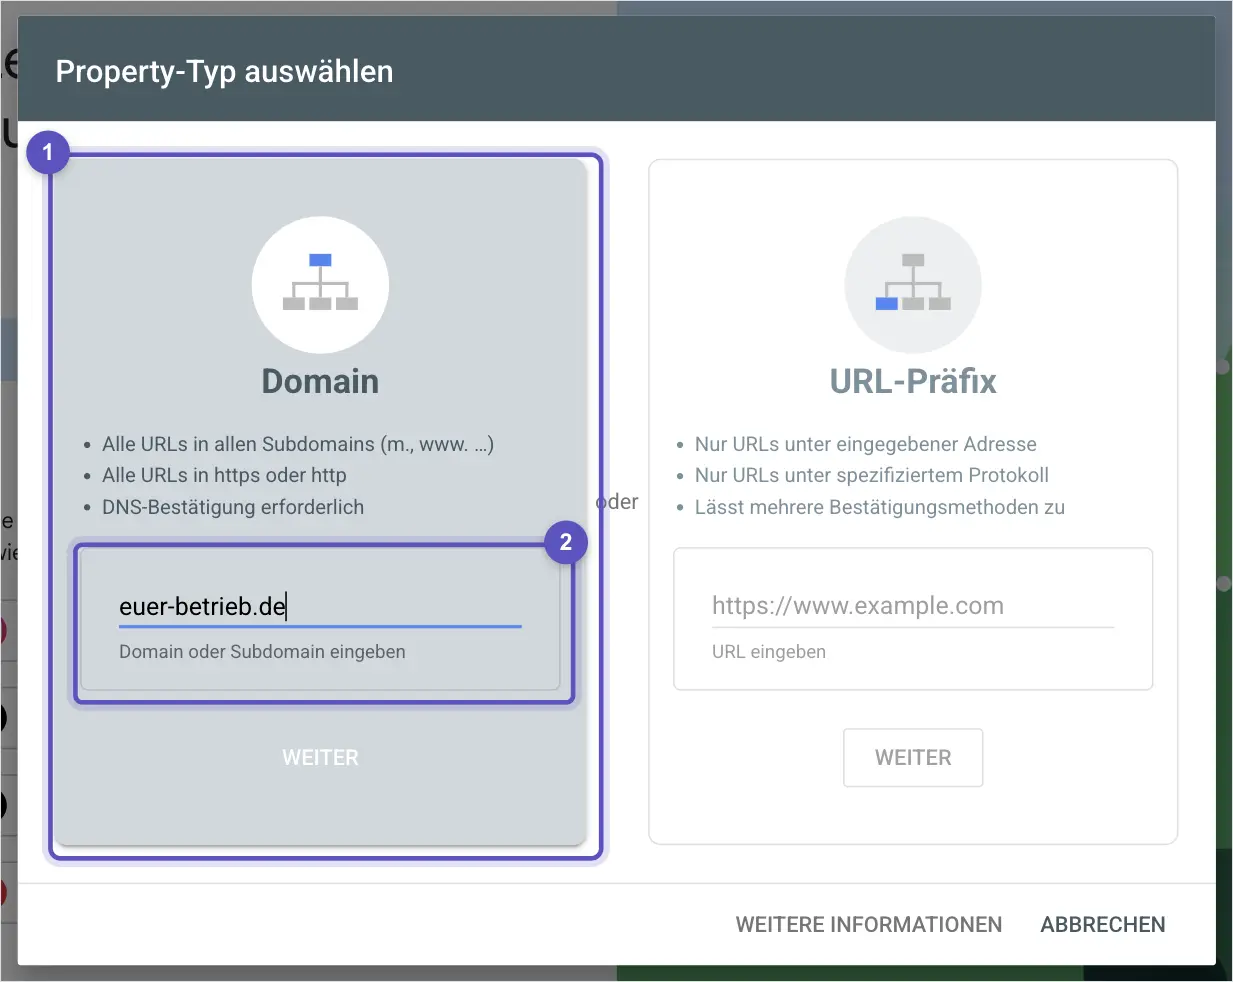
Der Einstieg über Website hinzufügen: Links wählt ihr die Domain-Property (1), ins Feld (2) kommt nur der Domainname, ohne https:// und ohne www. Aufnahme aus der Search Console, September 2026.
Wie oft das schiefgeht, sagt Google selbst, indem es den Fall als häufige Fehlerursache aufführt: „dass Sie die falsche URL angegeben haben (z. B. http statt https bei URL-Präfix-Properties)". Wer seine Property vor dem Umstieg auf https angelegt hat und seitdem nichts geändert hat, schaut heute auf eine Property, in der fast nichts mehr passiert.
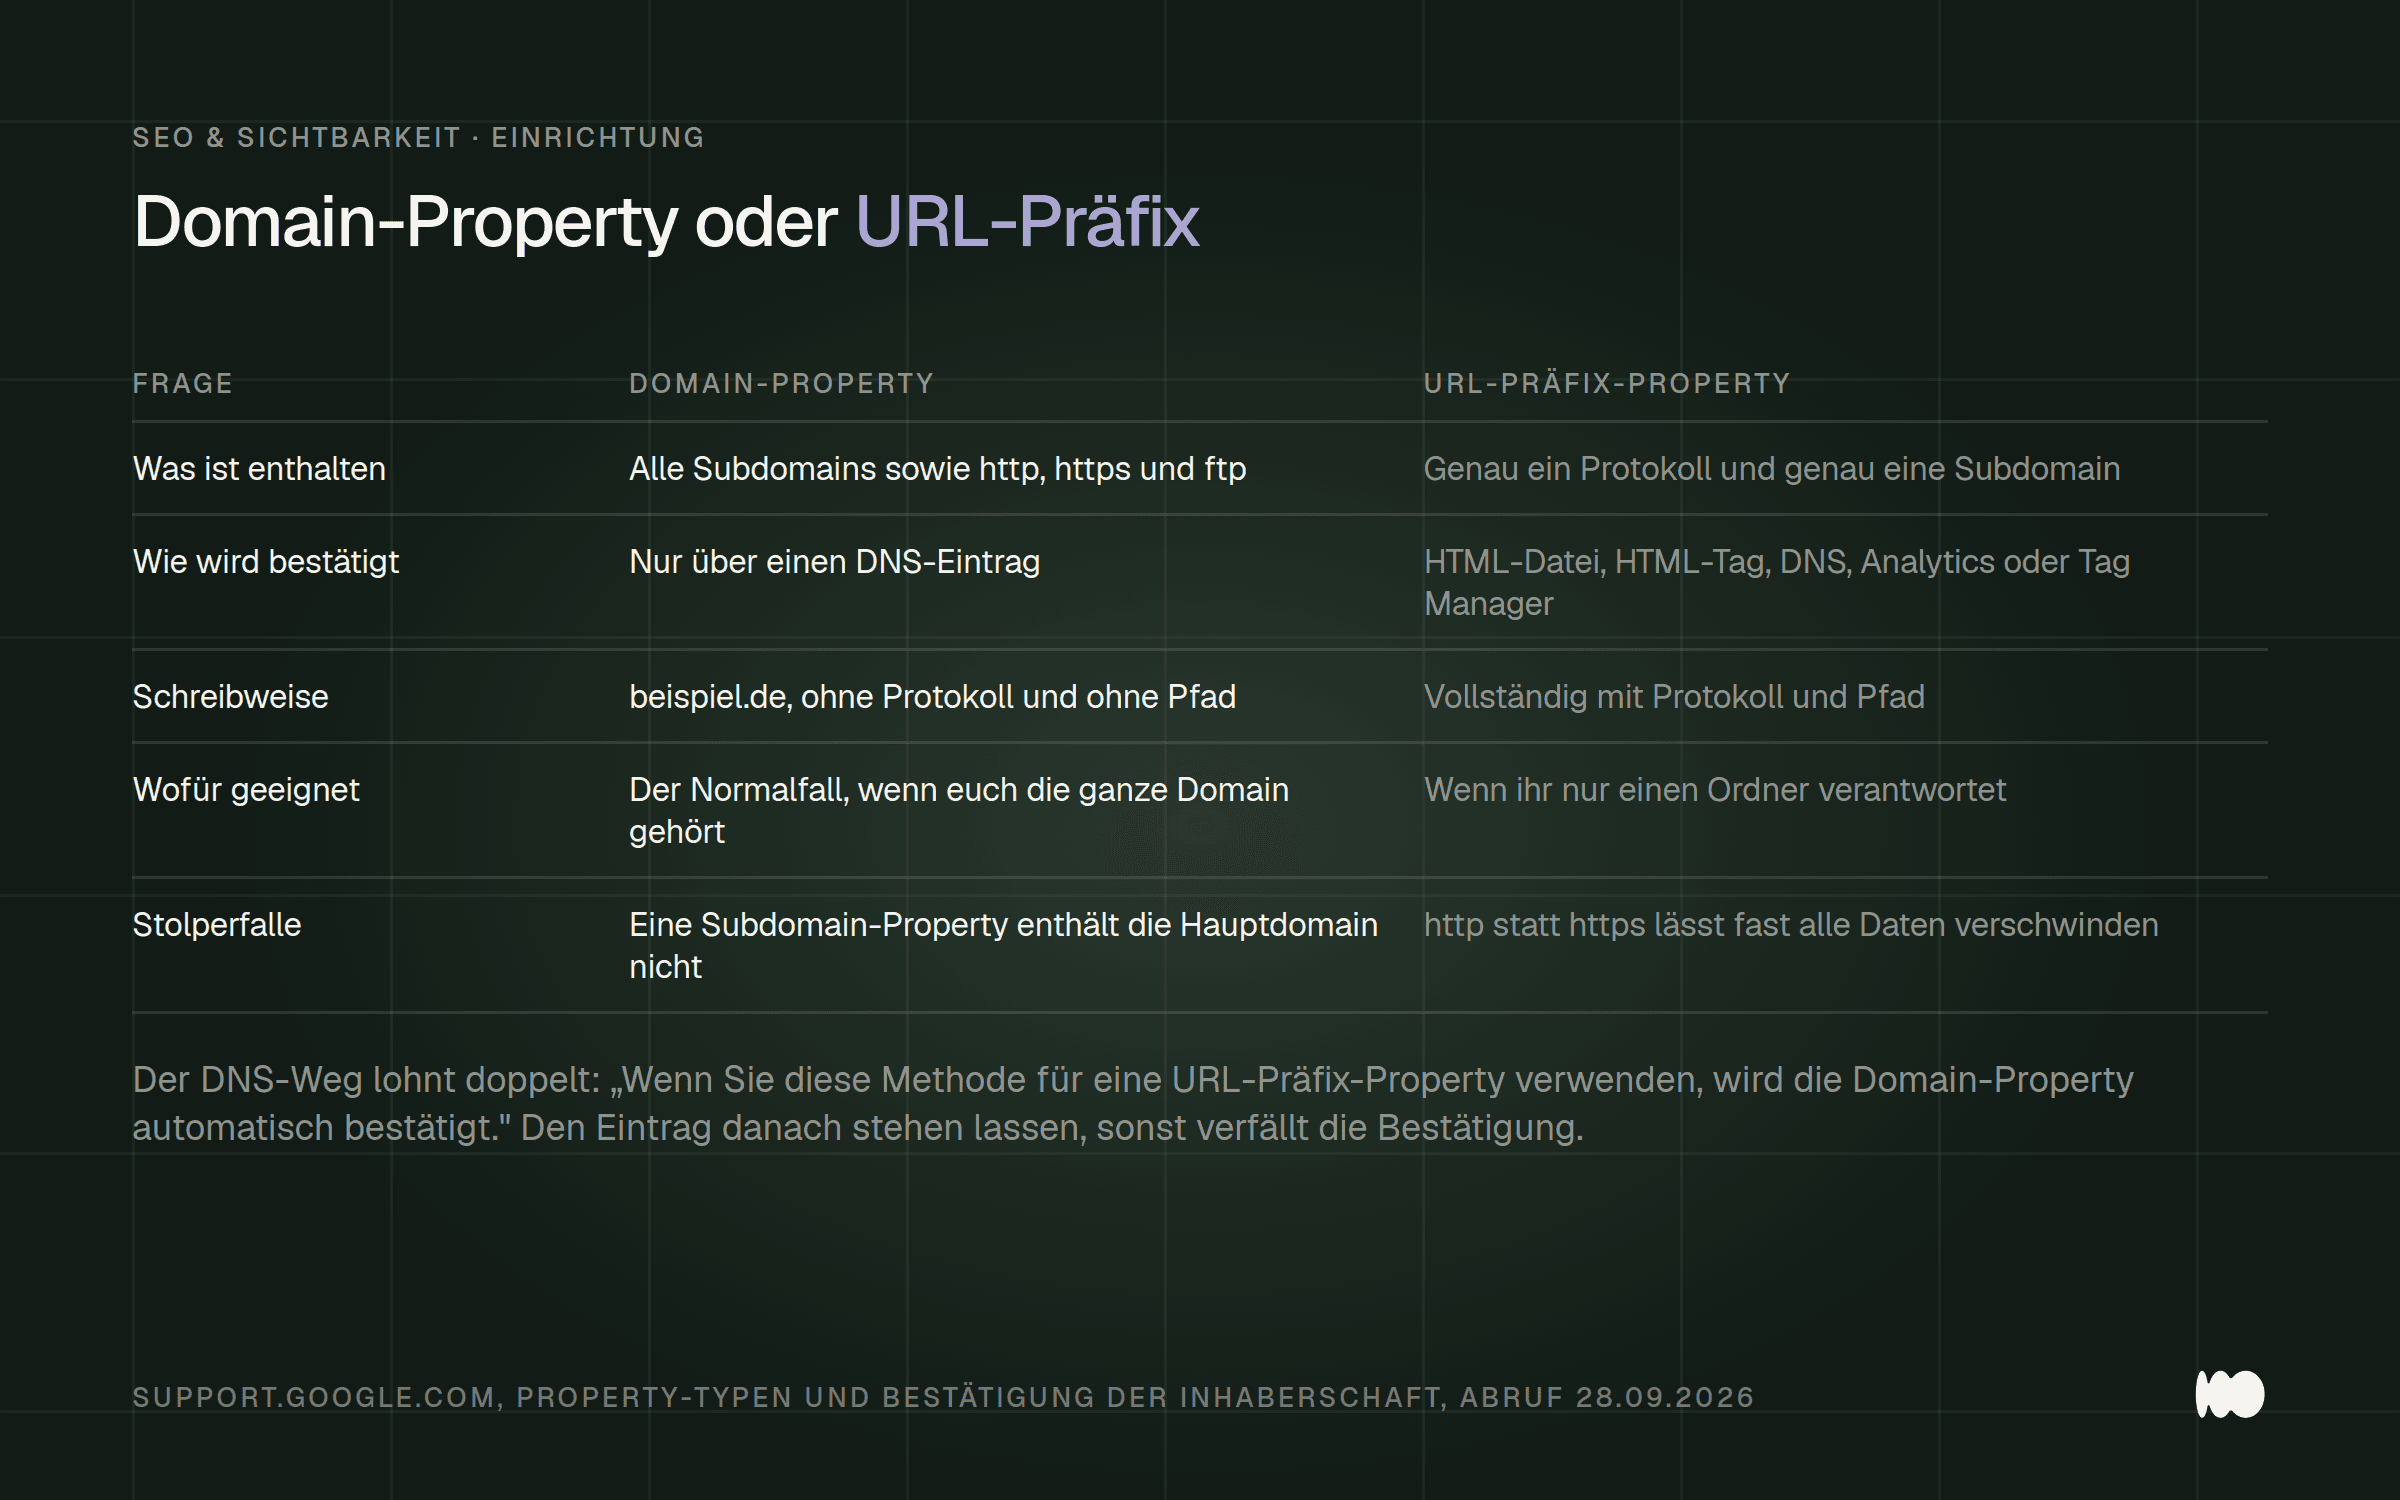
Was die beiden Property-Arten jeweils abdecken, und warum der Umweg über den DNS-Eintrag der schnellste Weg zur vollständigen Datengrundlage ist.
Hier der Handgriff, den kaum jemand kennt. Die Domain-Property lässt sich nur per DNS-Eintrag bestätigen, und genau dieser Weg schenkt euch beides: „Wenn Sie diese Methode für eine URL-Präfix-Property verwenden, wird die Domain-Property automatisch bestätigt." Wer also ohnehin den DNS-Eintrag setzt, bekommt die saubere Property gratis dazu und kann die alte behalten, wenn er will.
Zwei Dinge zur Syntax, an denen Anträge scheitern: In die Definition gehören weder Protokoll noch Pfad, und das www lasst ihr weg. Google formt es ohnehin um: „Wenn Sie also z. B. ‚www.beispiel.de' als Ihre Property-URL angeben, wird die Property als ‚beispiel.de' erstellt." Und Subdomains vererben nicht nach oben: Eine Property für shop.beispiel.de enthält keine Daten über beispiel.de.
Drei Fallen bei der Bestätigung selbst, die viel Zeit fressen. Der DNS-Eintrag muss dauerhaft stehen bleiben: „Entfernen Sie den DNS-Eintrag auch nach einer erfolgreichen Bestätigung nicht, damit die Bestätigung erhalten bleibt." Bei der HTML-Datei folgt Google keinen Weiterleitungen. Und beim Tag Manager muss der noscript-Teil unmittelbar hinter dem öffnenden body-Tag der Seite stehen, sonst schlägt die Bestätigung fehl.
Ein Rat aus Googles eigener Hilfe, den wir im Studio inzwischen bei jedem Kunden umsetzen: „Es kann sinnvoll sein, mehrere Bestätigungsmethoden für den Fall hinzuzufügen, dass eine Ihrer bestehenden Bestätigungsmethoden fehlschlägt." Zwei Methoden parallel kosten fünf Minuten und verhindern, dass ein Relaunch den Zugang mitnimmt.
Die vier Zahlen, und warum die durchschnittliche Position euch in die Irre führt
Hört auf, die durchschnittliche Position als Rangliste zu lesen, sie ist ein Mittelwert aus lauter Bestwerten. Google definiert sie als „die durchschnittliche Position des höchsten Ergebnisses Ihrer Website". Wenn eure Seite zu einer Suchanfrage auf 2, 4 und 6 erscheint, zählt nur die 2. Googles eigenes Beispiel rechnet zwei Suchanfragen mit den Bestwerten 2 und 3 zu einer durchschnittlichen Position von 2,5 zusammen.
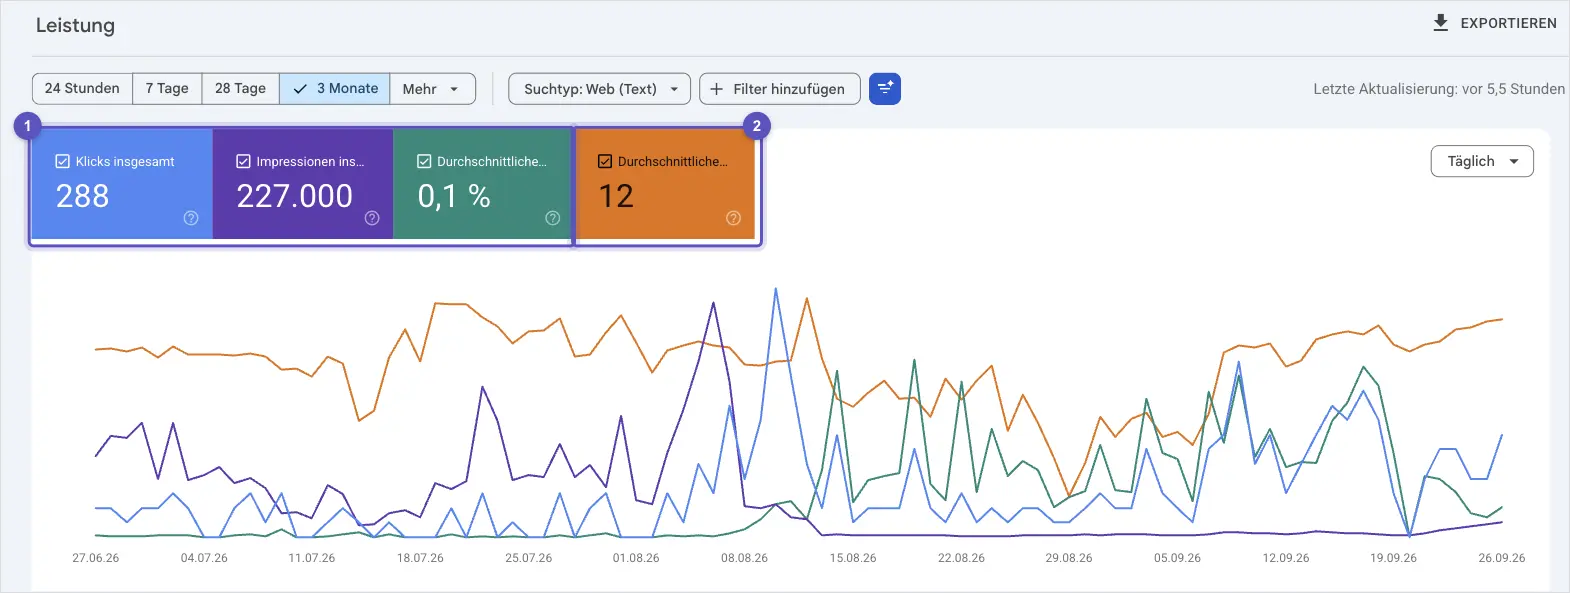
Der Leistungsbericht unserer eigenen Website, letzte drei Monate. Erst wenn ihr alle vier Kacheln anklickt (1), zeigt das Diagramm alle Werte. Die Position (2) steht bei 12, obwohl die wichtigste Suchanfrage im Schnitt auf 1,3 liegt: ein Mittelwert, keine Rangliste.
Noch wichtiger ist, was gar nicht erst mitzählt: „Ein Link muss eine Impression erzeugen, damit seine Position erfasst wird." Alles, was auf Seite drei liegt und nie gesehen wurde, fehlt in der Rechnung. Eure Position kann sich also verbessern, weil schlecht platzierte Treffer verschwunden sind. Google selbst zieht die Konsequenz: „Generell ist es empfehlenswert, sich stärker auf Trends bei Impressionen und Klicks als auf die Position zu konzentrieren."
Die zweite Falle erklärt fast jede Zahl, die nicht aufgeht. Es gibt zwei Zählweisen, nach Property und nach Seite, und das Diagramm nutzt „unabhängig von der ausgewählten Dimension immer" die Zählung nach Property. Die Tabelle wechselt dagegen auf die Zählung nach Seite, sobald ihr auf den Tab Seiten oder Darstellung in der Suche geht.
Was das anrichtet, zeigt Google an einem eigenen Beispiel: Drei URLs derselben Website erscheinen zu einer Suchanfrage, jemand klickt alle drei an. Nach Property sind das 100 Prozent Klickrate und Position 1. Nach Seite sind es 33 Prozent je URL und Position 2. Dieselbe Wirklichkeit, zwei Zahlensätze. Wer Klickraten aus dem Seiten-Tab mit Klickraten aus dem Diagramm vergleicht, vergleicht zwei verschiedene Maßeinheiten.
Und sobald ihr filtert, stimmen die Summen prinzipiell nicht mehr. Die Tabelle fasst „maximal 1.000 Zeilen", seltene Suchanfragen werden aus Datenschutzgründen weggelassen, und Google schreibt ausdrücklich, dass „stimmt überein mit" und „stimmt nicht überein mit" zusammen nicht den ungefilterten Gesamtwert ergeben müssen. Nehmt die gefilterten Zahlen also als Richtung, nicht als Buchhaltung.
Reguläre Ausdrücke: der Hebel, den fast niemand benutzt
Legt euch drei bis vier Regex-Filter zurecht und ihr bekommt Antworten, die die Standardansicht nicht kennt. Der Weg dorthin: in der Filterzeile auf + Filter hinzufügen, dann Suchanfrage oder Seite, dann Benutzerdefiniert (Regex). Es ist derselbe Bericht, nur mit einer Frage, die ihr selbst stellt.
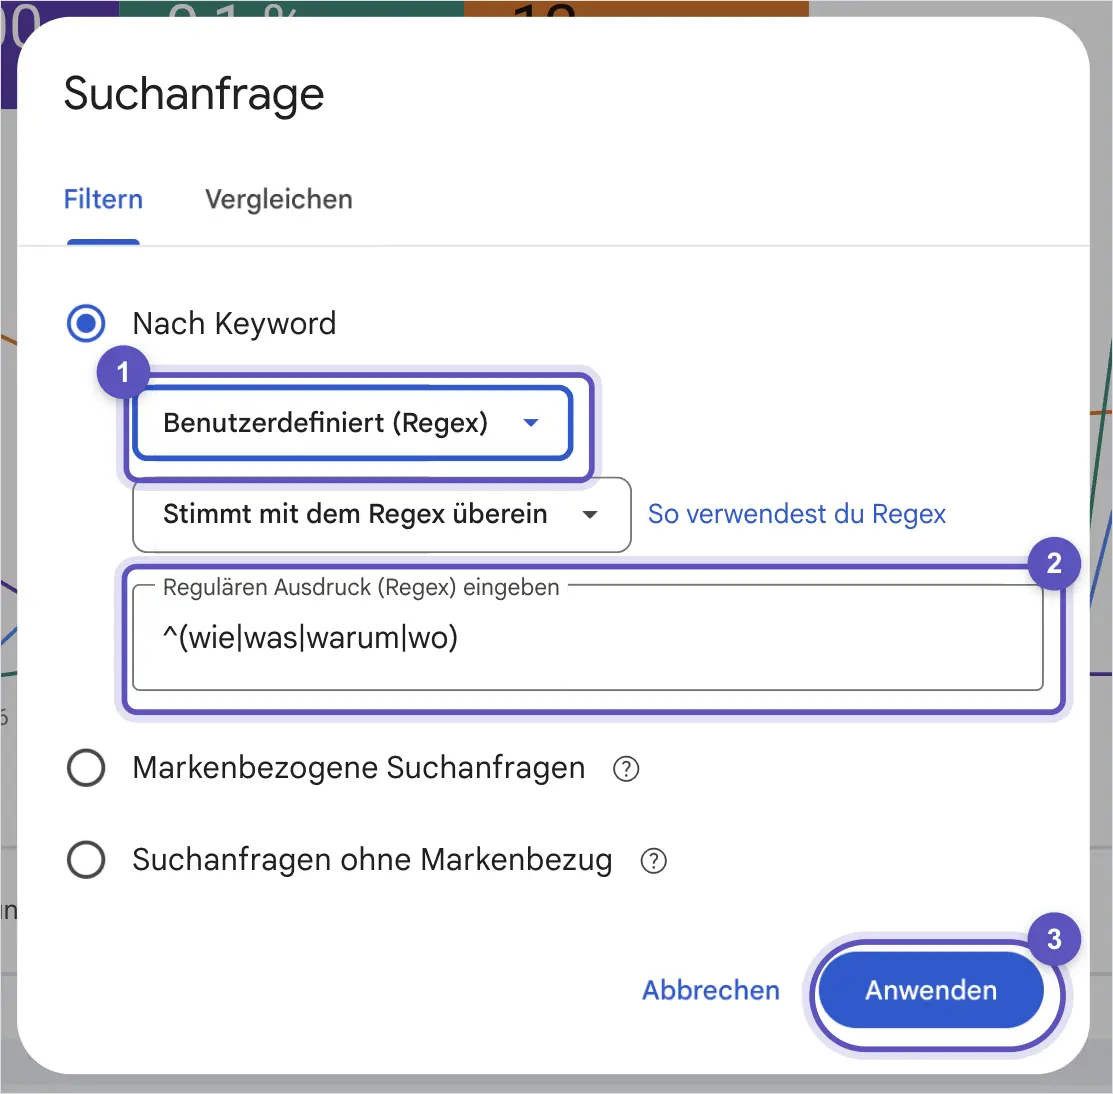
Der Regex-Filter in drei Schritten: Benutzerdefiniert (Regex) wählen (1), Muster eintragen (2), Anwenden (3). Das Beispiel ^(wie|was|warum|wo) zeigt nur Suchanfragen, die mit einem Fragewort beginnen. Darunter stehen die beiden Filter für Suchanfragen mit und ohne Markenbezug.
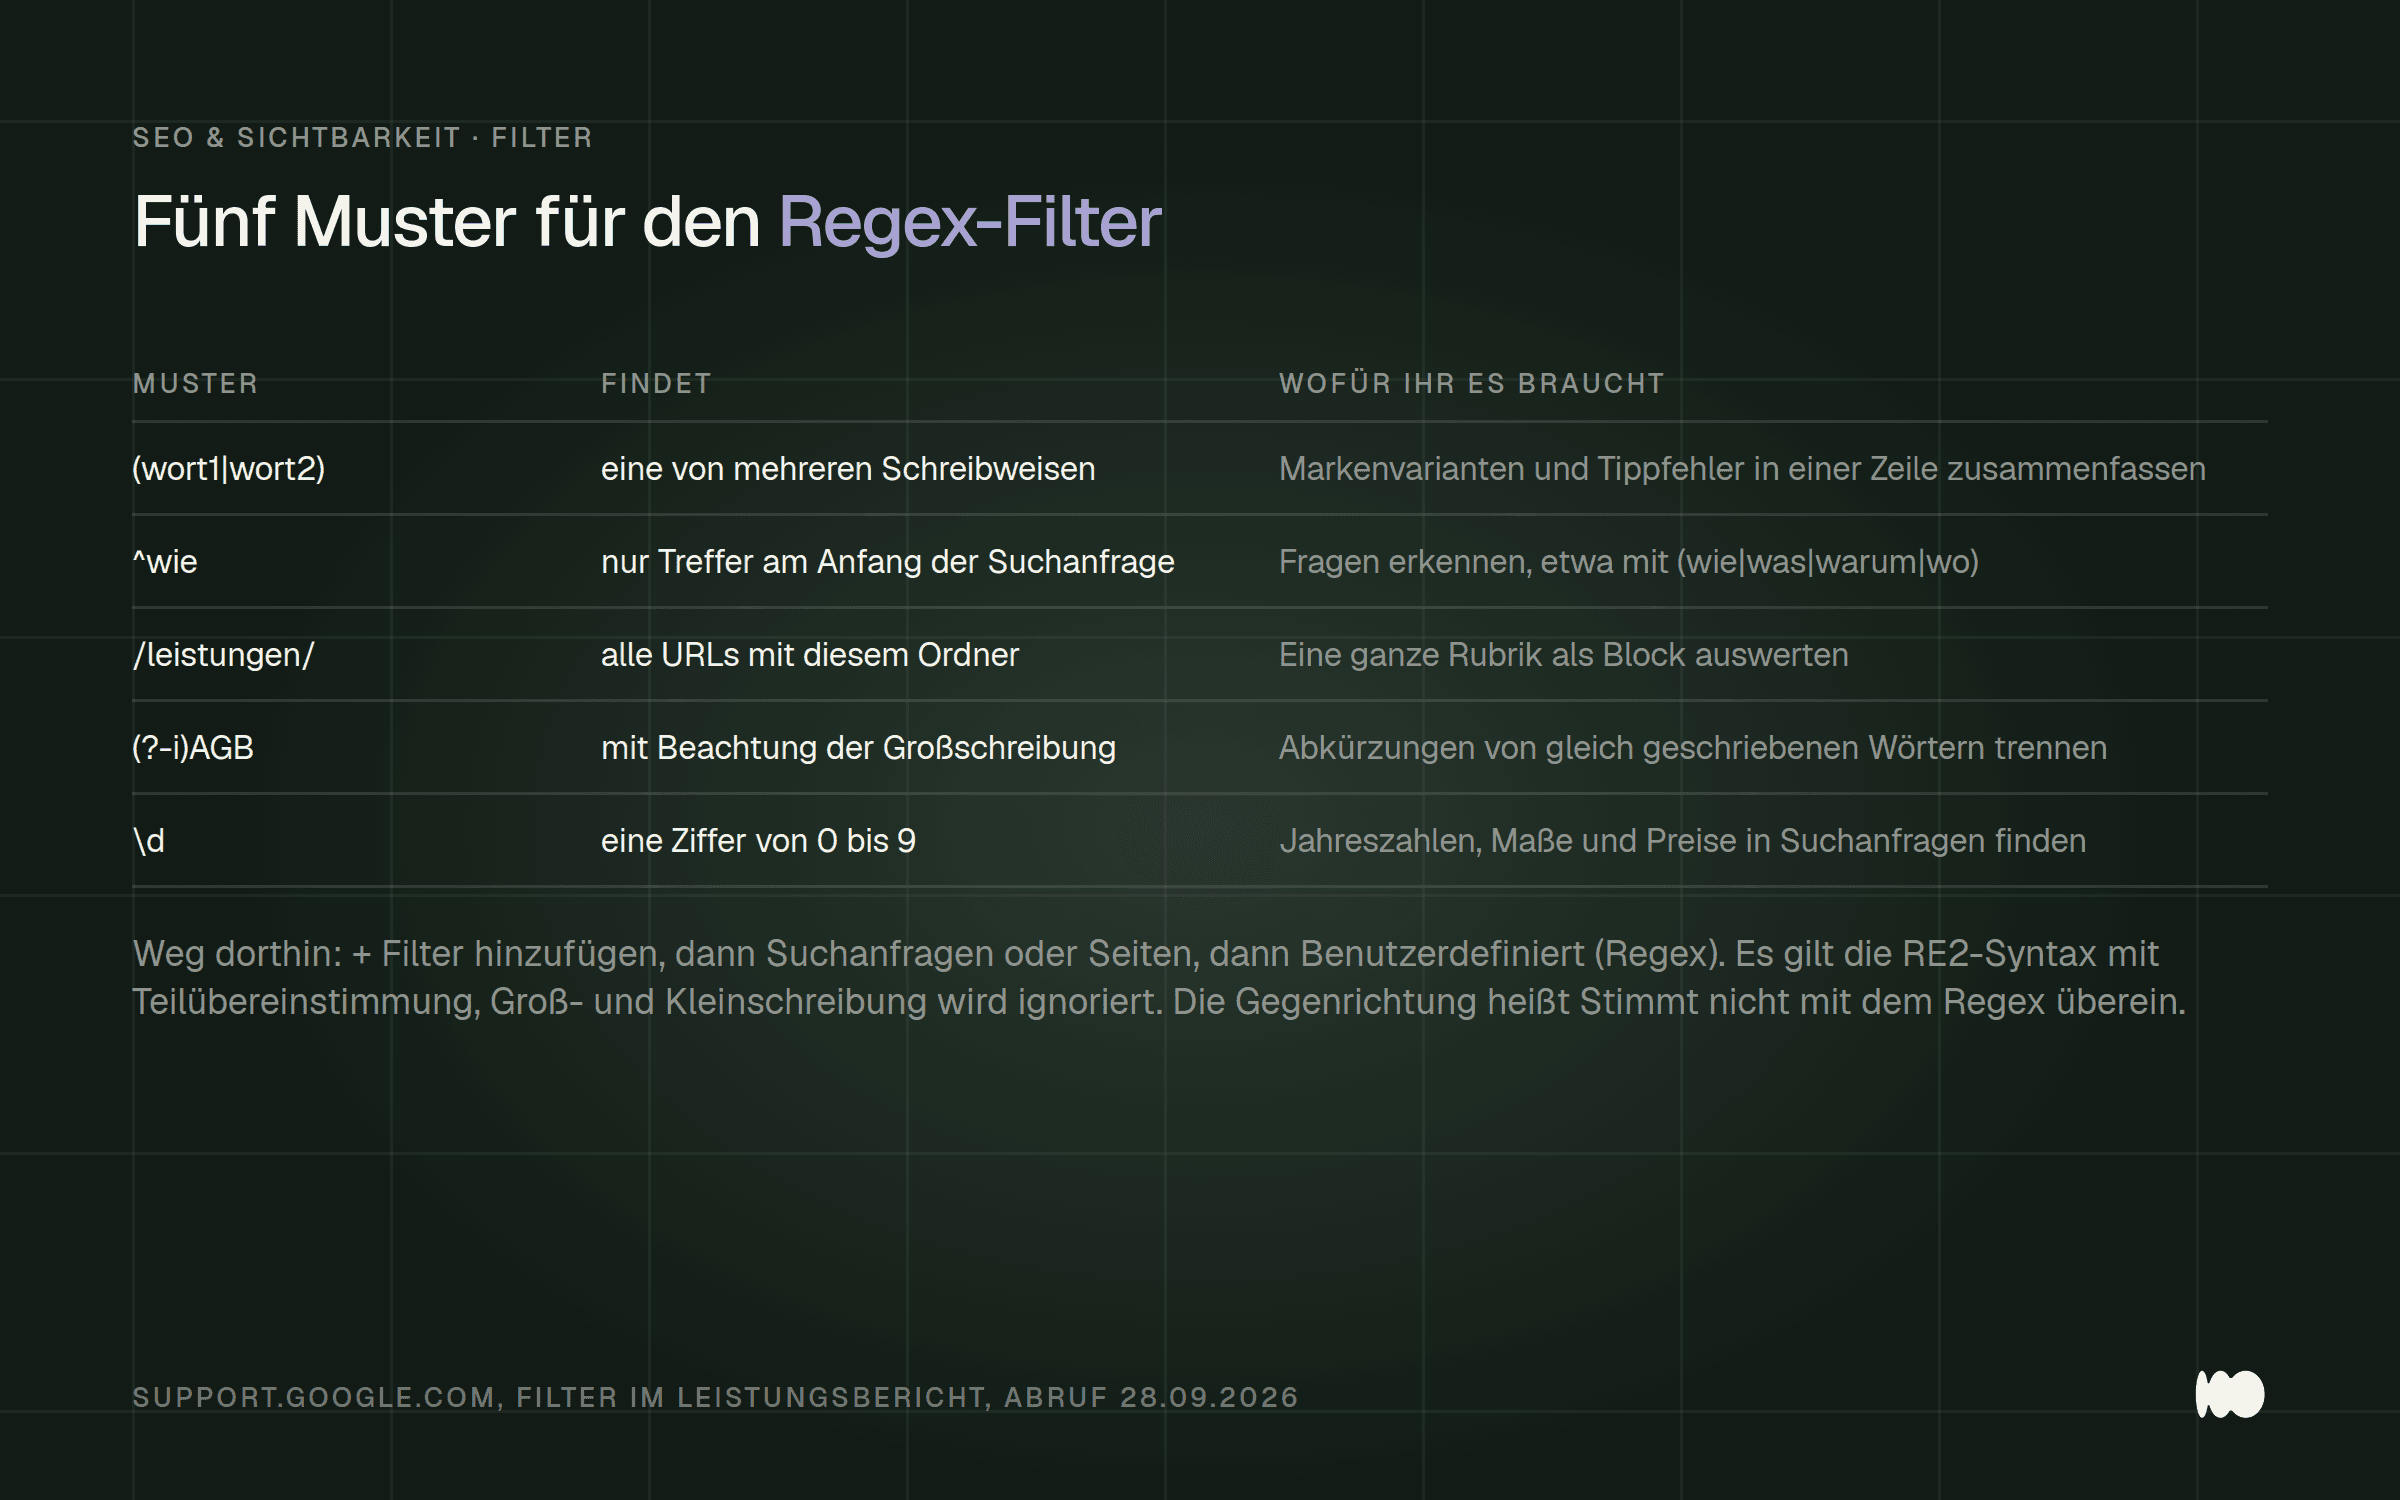
Vier Muster, die im Betrieb sofort etwas bringen, jeweils mit der Frage, die sie beantworten. Die Syntax stammt aus Googles eigener Beispieltabelle.
Drei Regeln müsst ihr kennen, dann funktioniert es. Google benutzt die RE2-Syntax. Der Abgleich ist eine Teilübereinstimmung: „Ihr regulärer Ausdruck kann mit einem beliebigen Teil des Zielstrings übereinstimmen, es sei denn, Sie verwenden ^ (Anfang des Strings) oder $ (Ende des Strings)." Und Groß- und Kleinschreibung werden standardmäßig ignoriert; wer sie beachten will, stellt (?-i) voran.
Mehrere Begriffe trennt ihr mit einem senkrechten Strich und klammert das Ganze ein, also in der Form (wert1|wert2|wert3). Für die Gegenrichtung gibt es die Option Stimmt nicht mit dem Regex überein, und genau die ist im Alltag oft die nützlichere: Damit blendet ihr eure Marke aus und seht, was ohne Namensnennung ankommt.
Inzwischen gibt es dafür auch einen eingebauten Weg, den Filter für Suchanfragen mit und ohne Markenbezug. Zwei Dinge solltet ihr dazu wissen. Er arbeitet ausdrücklich nicht mit Stichwortlisten, sondern mit einem internen, KI-gestützten System, und Google räumt selbst ein, dass einzelne Suchanfragen dabei gelegentlich falsch einsortiert werden. Außerdem steht er nur für Properties auf oberster Ebene zur Verfügung, nicht für Unterordner oder Subdomains. Für alles darunter bleibt der Regex-Filter das Mittel der Wahl.
Seiten finden, die knapp vor der ersten Ergebnisseite stehen
Sucht nicht nach dem, was fehlt, sondern nach dem, was fast schon da ist. Suchanfragen, zu denen ihr auf Position 8 bis 20 erscheint, haben die Arbeit hinter sich: Google kennt die Seite, hält sie für passend und zeigt sie. Es fehlt wenig, und das Wenige ist meistens Text auf der Seite selbst, nicht ein neues Projekt.
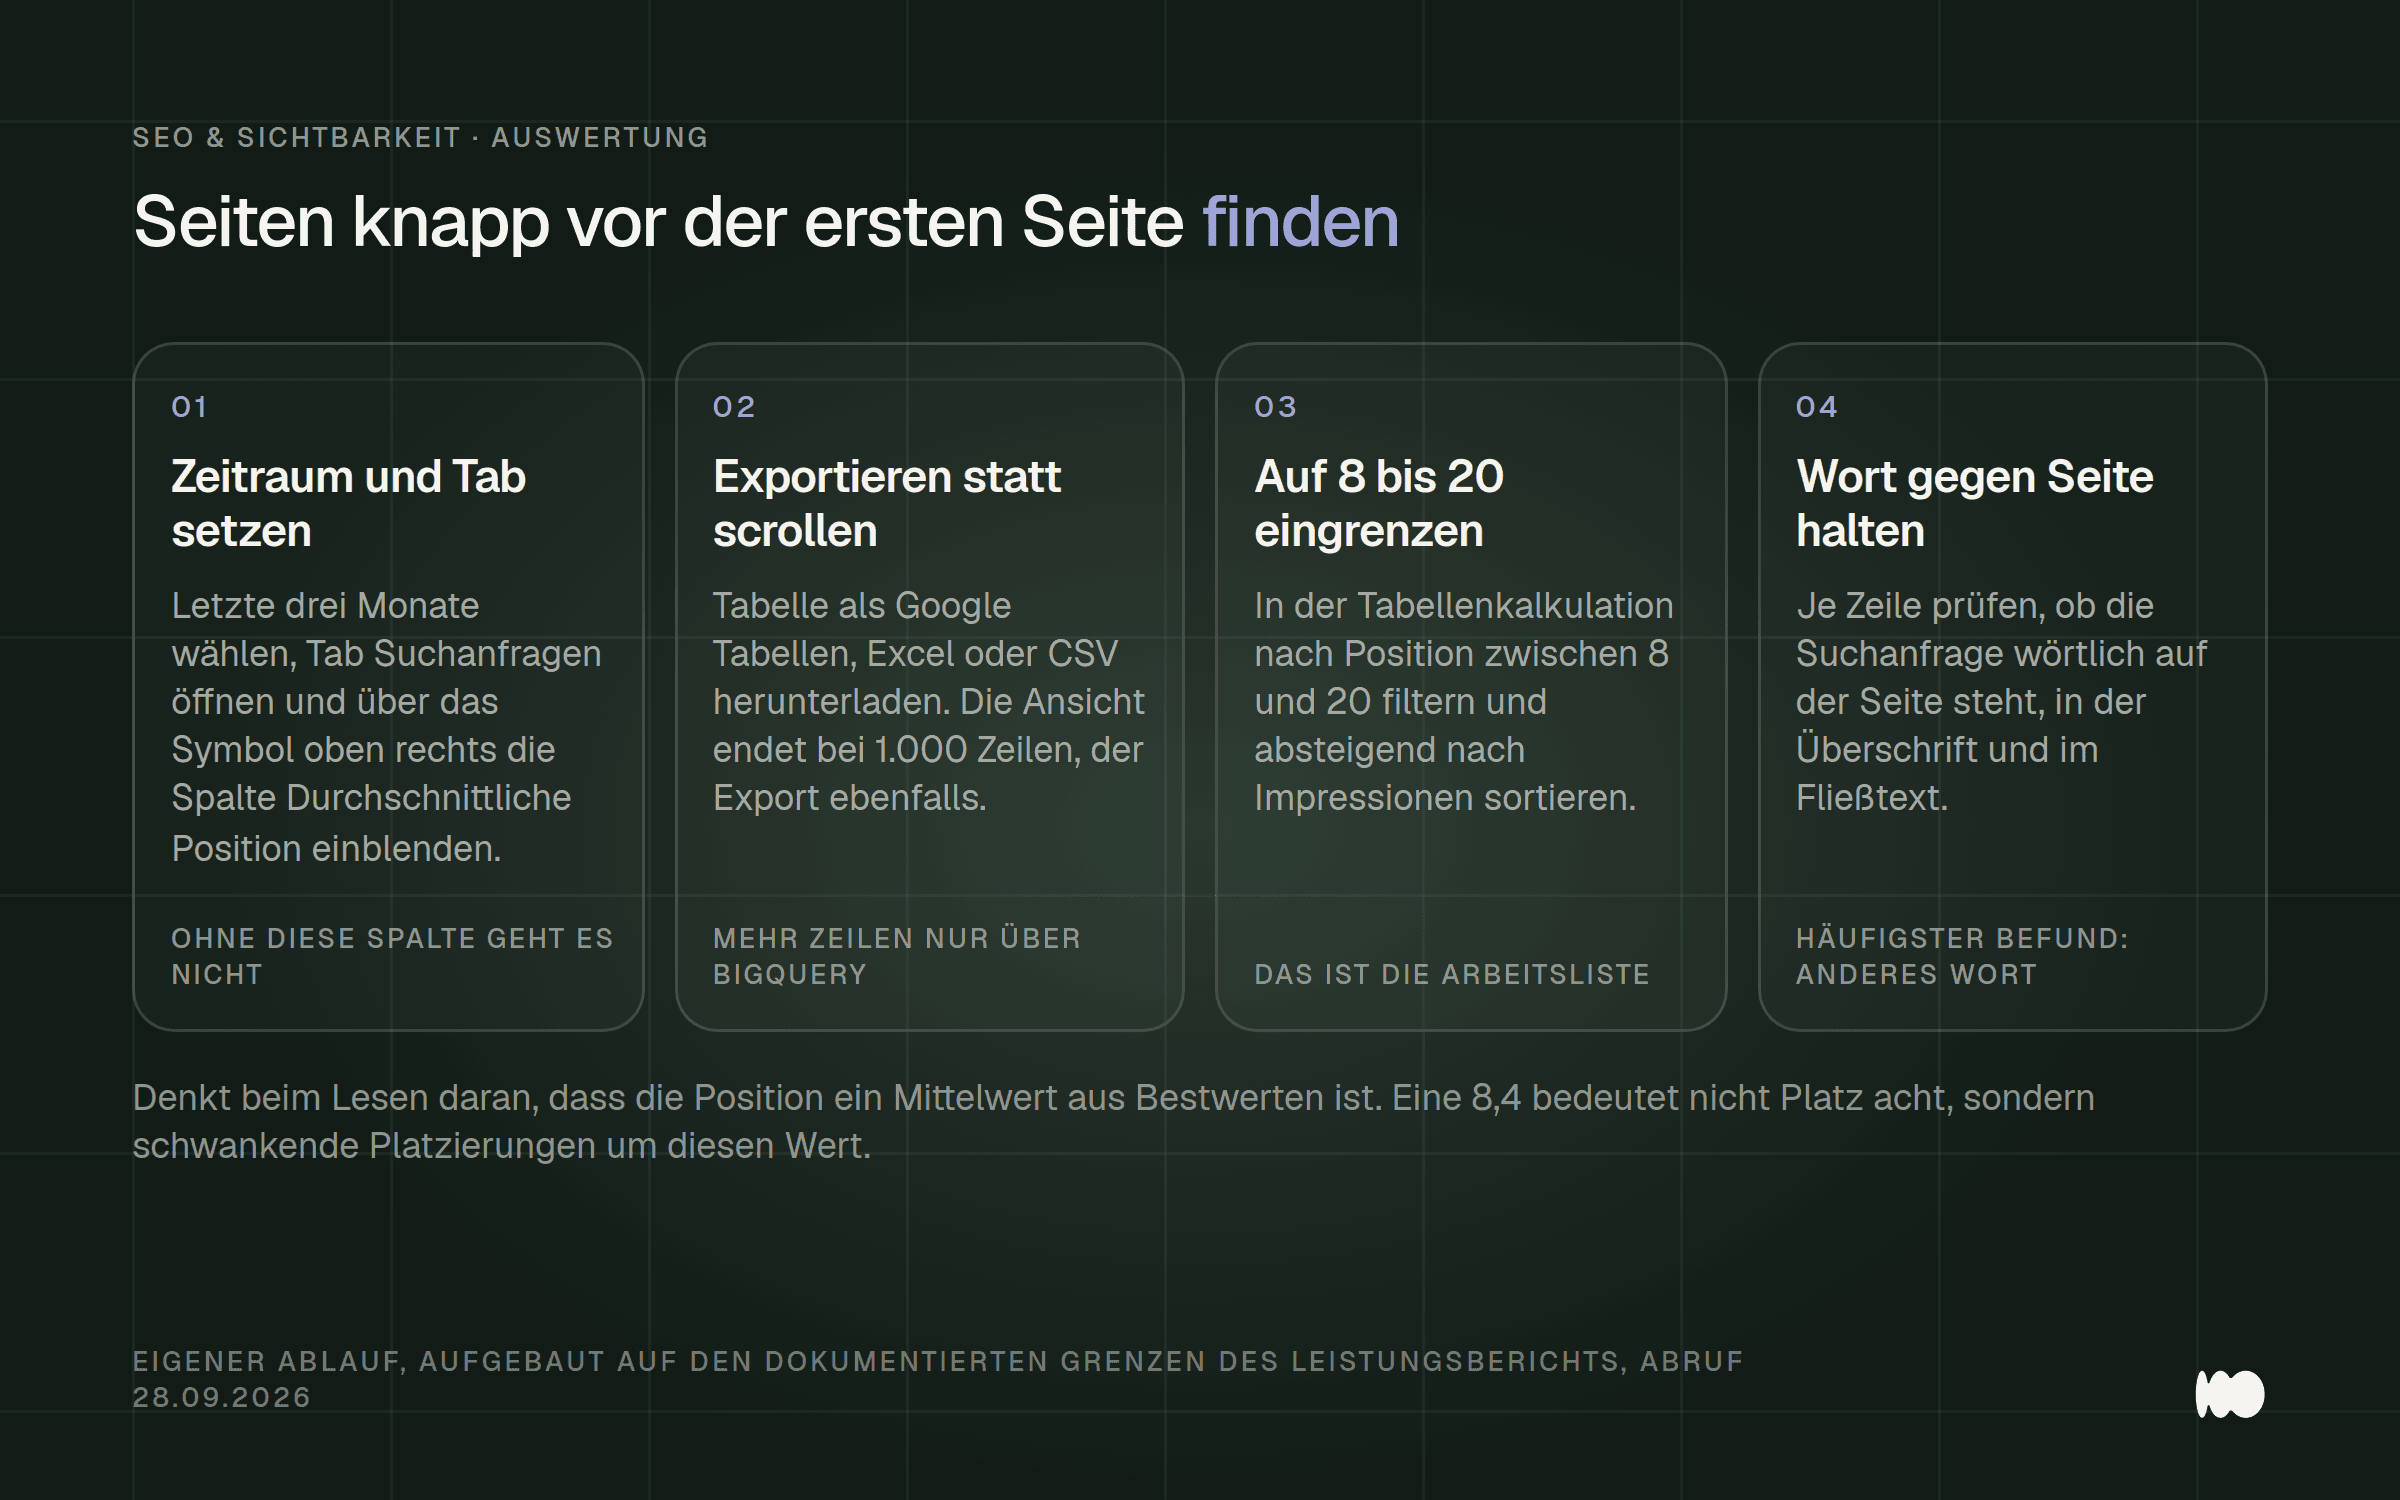
Die Auswertung in vier Schritten. Sie kommt ohne Zusatzwerkzeug aus, braucht aber den Export, weil die Tabelle bei 1.000 Zeilen endet.
Der Ablauf im Werkzeug: Zeitraum auf die letzten drei Monate, Tab Suchanfragen, und die Spalte Durchschnittliche Position über das Symbol oben rechts einblenden. Für einen ersten Blick reicht das Filtersymbol der Tabelle mit Position, Größer als 8. Für die eigentliche Arbeitsliste exportiert ihr trotzdem, denn die Tabelle endet bei 1.000 Zeilen. Wer regelmäßig mehr braucht, richtet den Bulk-Export nach BigQuery ein.
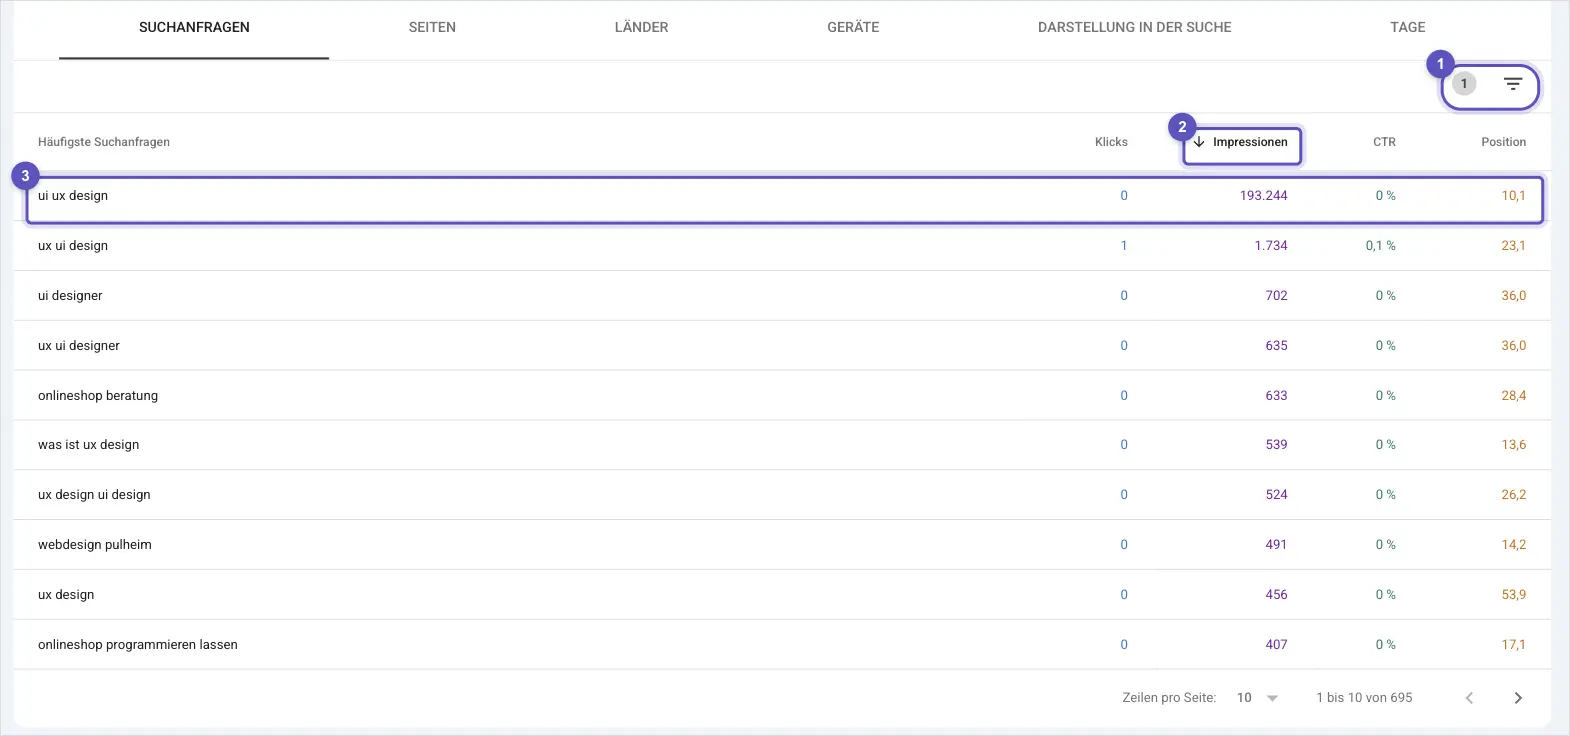
Über das Filtersymbol der Tabelle (1) begrenzt ihr die Position auf Größer als 8 und sortiert dann nach Impressionen (2). Bei uns steht ganz oben „ui ux design" (3): über 193.000 Impressionen auf Position 10,1 und kein einziger Klick. So sieht ein Kandidat knapp vor der ersten Seite aus.
In der Tabellenkalkulation nehmt ihr dann die Zeilen mit einer Position zwischen 8 und 20 und mindestens einer Handvoll Impressionen. Was übrig bleibt, ist eure Arbeitsliste, sortiert nach Impressionen. Denkt beim Lesen daran, dass die Position ein Mittelwert aus Bestwerten ist: Eine 8,4 bedeutet nicht Platz acht, sondern schwankende Platzierungen um diesen Wert herum.
Was wir im Studio dabei regelmäßig sehen: Die Suchanfrage steht in keiner Überschrift der Seite, oft nicht einmal im Fließtext, weil intern ein anderes Wort benutzt wird als draußen. Der Handwerksbetrieb schreibt „Sanitärinstallation", gesucht wird „Bad renovieren". Das ist kein SEO-Problem, das ist ein Wortschatzproblem, und es lässt sich an einem Nachmittag beheben.
Wenn zwei eigene Seiten um dieselbe Suchanfrage konkurrieren
Filtert auf eine einzelne Suchanfrage und wechselt dann auf den Tab Seiten, dann seht ihr, ob ihr gegen euch selbst antretet. Das ist der schnellste Weg, ein Problem zu finden, das sonst unsichtbar bleibt: Zwei ähnliche Seiten, dieselbe Suchanfrage, und Google entscheidet mal für die eine und mal für die andere. Beide sammeln Impressionen, keine setzt sich durch.
Wundert euch dabei nicht über die Zahlen. Mit dem Wechsel auf Seiten wechselt auch die Zählweise, deshalb sinken Klickrate und Position gegenüber der Diagrammansicht. Das ist kein Fehler, sondern genau der Effekt aus dem ersten Abschnitt.
Die zweite Hälfte des Bildes liefert der Indexierungsbericht. Findet ihr dort den Status Duplikat, vom Nutzer nicht als kanonisch festgelegt, hat Google die Entscheidung bereits getroffen. Google nennt das ausdrücklich „kein Fehler, sondern durchaus beabsichtigt" und gibt euch zwei Auswege: die kanonische Seite selbst festlegen, oder dafür sorgen, „dass sich der Inhalt zwischen den beiden Seiten erheblich unterscheidet".
Ein Detail, das beim Aufräumen hilft: Google weist Klicks, Impressionen und Position „der kanonischen URL" zu, die es selbst ausgewählt hat. Eine Seite kann also Daten sammeln, die eigentlich von einer anderen URL stammen. Welche das ist, steht im URL-Prüftool unter Indexierung.
Seitenindexierung: die zwei Statusgründe, bei denen fast alle das Falsche tun
Lest die Statusgründe wörtlich, bevor ihr etwas repariert, denn die Hälfte davon verlangt gar keine Reparatur. Google stellt der ganzen Kategorie einen Satz voran, den kaum jemand ernst nimmt: „Diese Seiten wurden nicht indexiert. Der Grund war jedoch nicht unbedingt ein Fehler." Eine rote Zahl im Bericht ist also erst einmal eine Zählung, keine Mängelliste.
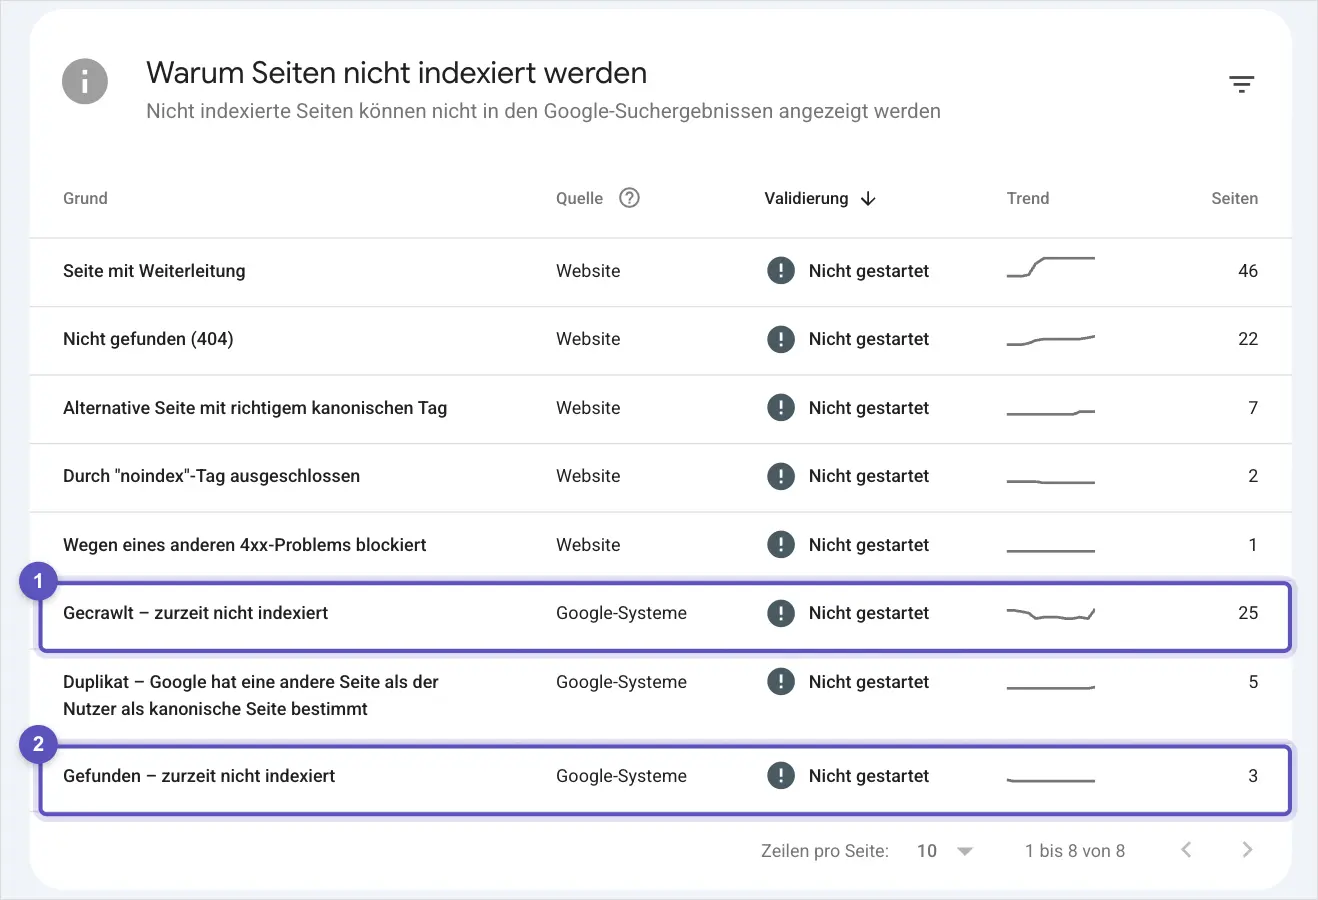
Der Bericht Seitenindexierung für unsere Website. Die Spalte Quelle trennt, was die Website verursacht, von dem, was Google-Systeme entschieden haben. Markiert sind die beiden Statusgründe aus diesem Abschnitt (1, 2).
Der erste Status, an dem sich Betriebe festbeißen, heißt Gecrawlt – zurzeit nicht indexiert. Google schreibt dazu: „Die Seite wurde von Google gecrawlt, aber nicht indexiert. Sie könnte jedoch in Zukunft indexiert werden. Sie brauchen diese URL nicht noch einmal zum Crawling einzureichen." Der letzte Satz ist eine ausdrückliche Absage an das Nachfassen. Wer die Seite trotzdem jede Woche neu einreicht, verbrennt nur sein Tageskontingent.
Der zweite ist der eigentliche Aha-Moment. Bei Gefunden – zurzeit nicht indexiert schreibt Google: „Wird diese Begründung angegeben, hat Google normalerweise versucht, die URL zu crawlen, aber das hätte die Website überlastet. Daher hat Google das Crawling neu geplant." Die belegte Ursache ist also euer Server, nicht euer Text. Jeder Ratschlag, an dieser Stelle den Inhalt zu verbessern, geht am Befund vorbei; die Antwort liegt in Antwortzeiten und Hosting.
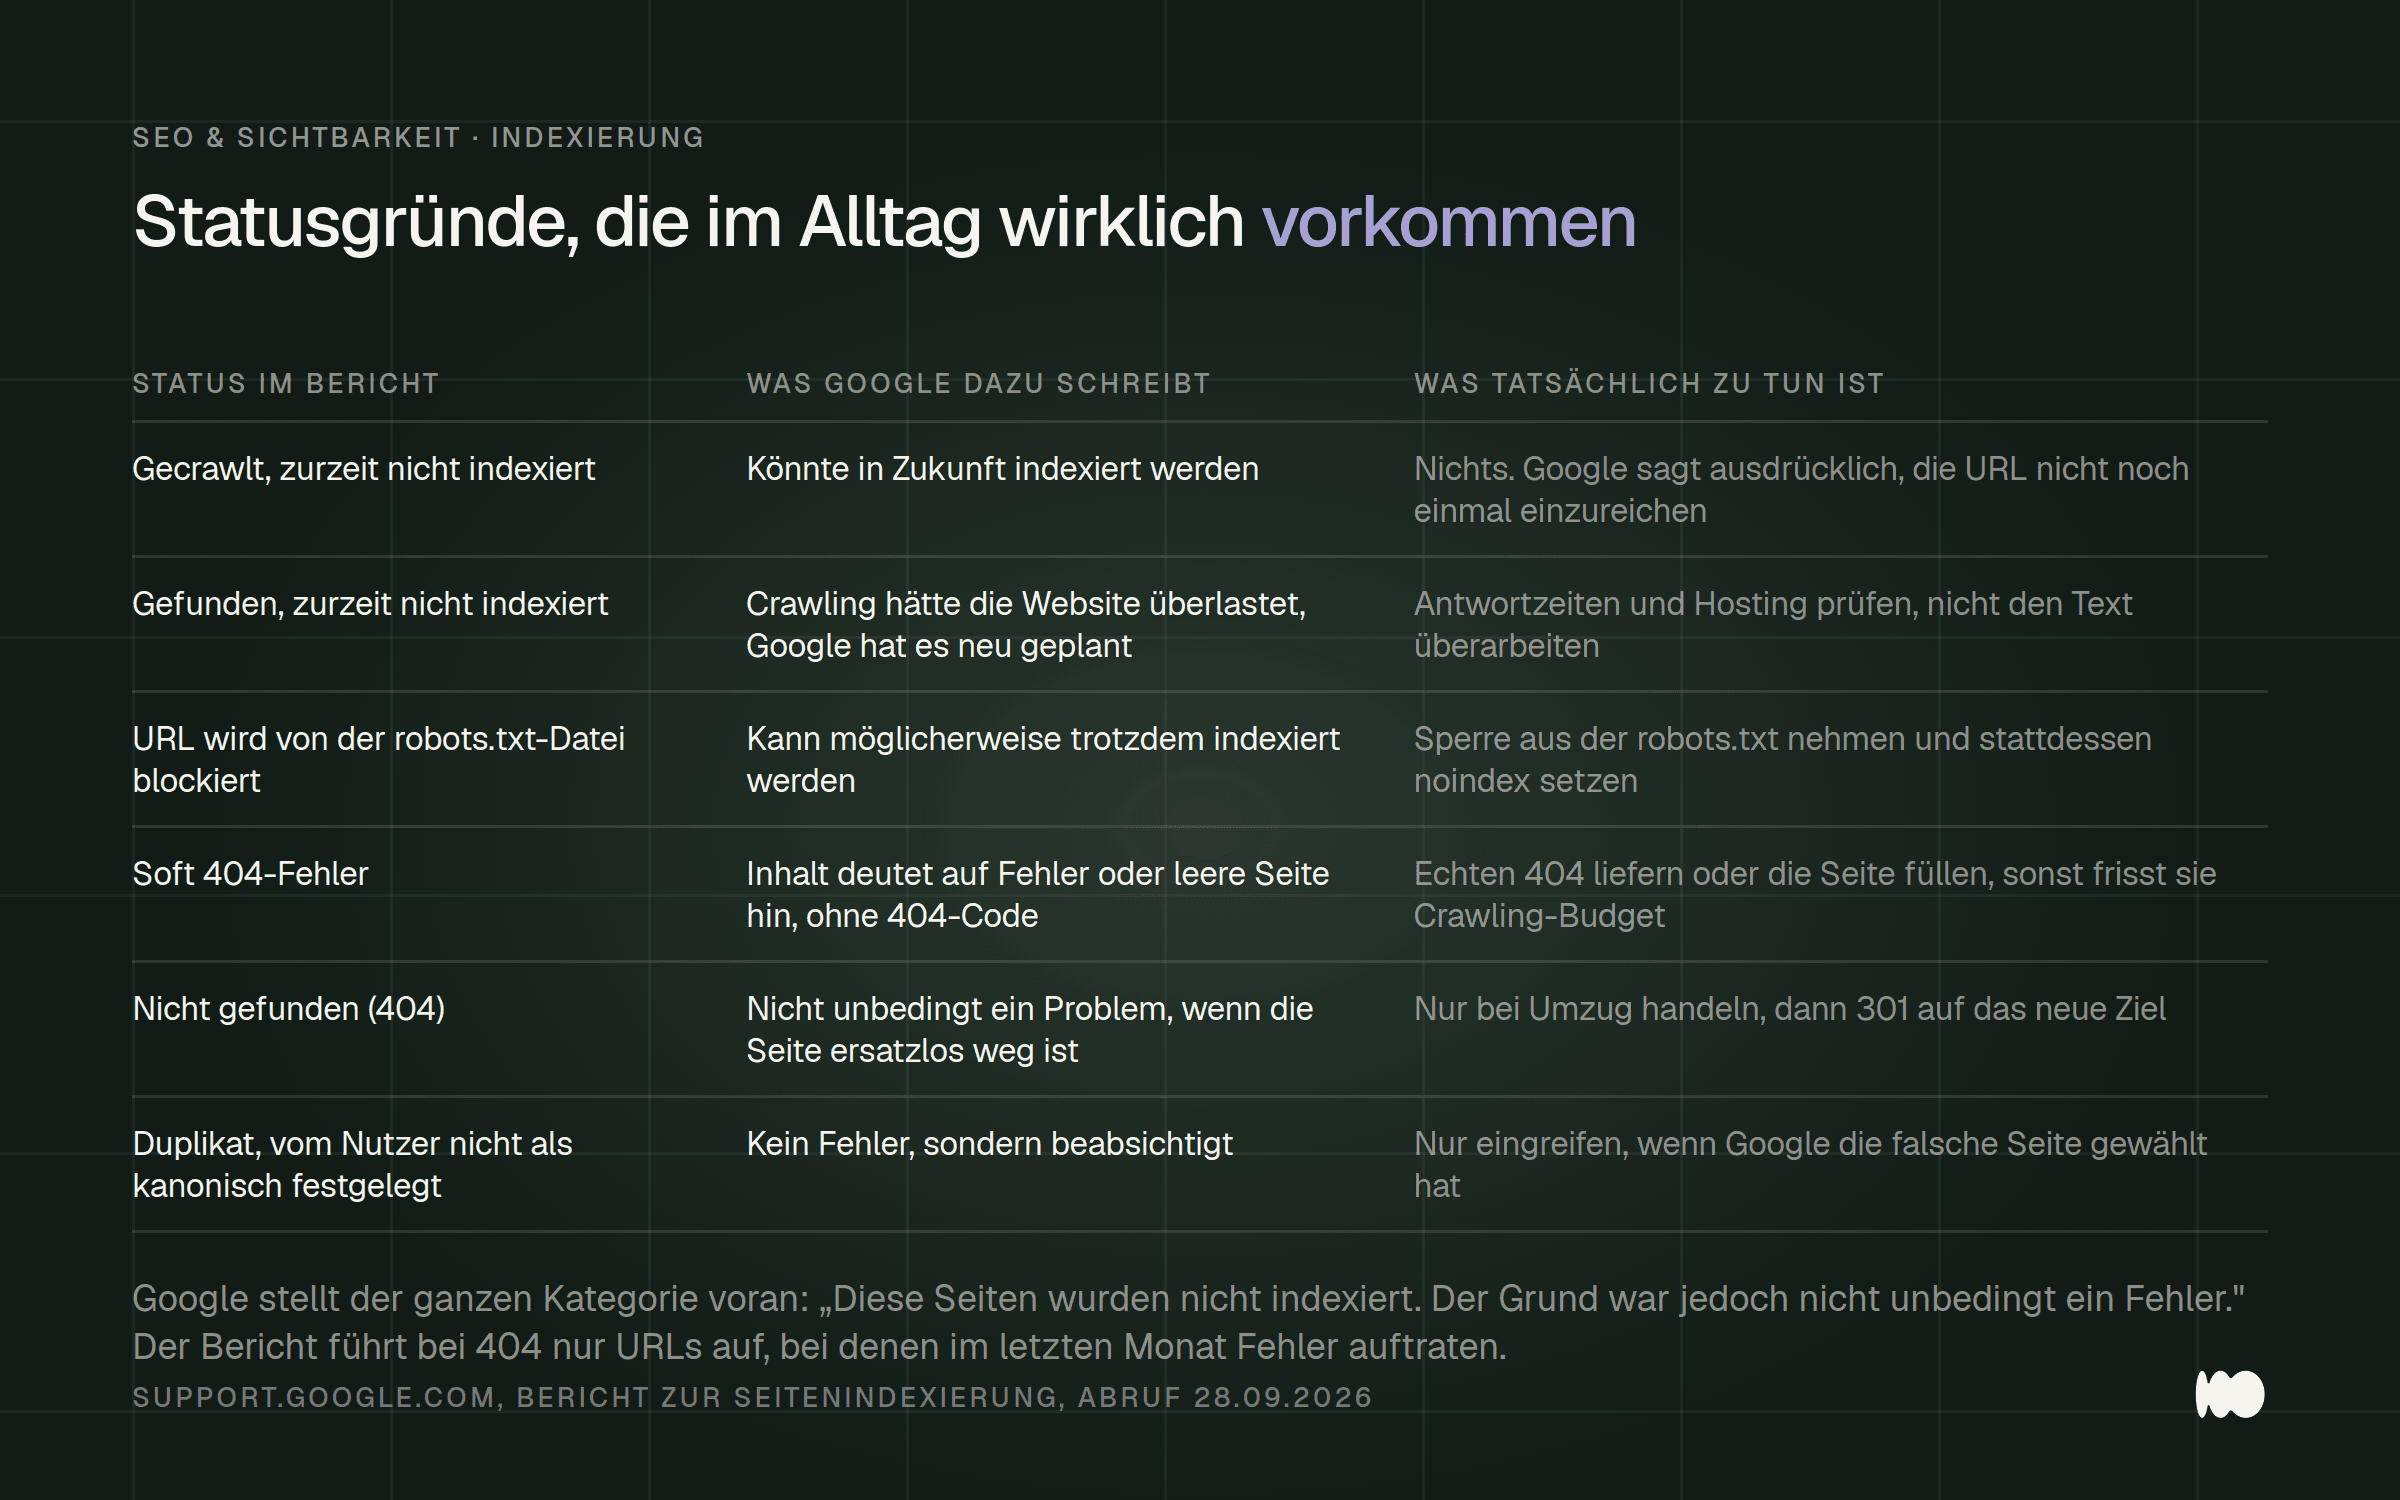
Die Statusgründe, die im Alltag wirklich vorkommen, mit Googles eigener Einordnung und dem, was tatsächlich zu tun ist.
Zwei weitere Stellen sind falsch verstanden im Umlauf. URL wird von der robots.txt-Datei blockiert heißt nicht, dass die Seite draußen bleibt: „Beachten Sie, dass Ihre Seite möglicherweise trotzdem über eine andere Methode indexiert werden kann." Wer eine Seite sicher heraushalten will, nimmt laut Google die Anweisung noindex und entfernt die Sperre in der robots.txt. Beides gleichzeitig ist der klassische Selbstschuss, weil Google die noindex-Anweisung dann gar nicht erst lesen kann.
Und Soft 404-Fehler betrifft nicht nur kaputte Seiten. Es genügt, dass eine normal antwortende Seite wie ein Fehler aussieht: „Wenn der Inhalt auf einen Fehler für die Google Suche, eine leere Seite oder eine Fehlermeldung hindeutet, zeigt die Search Console einen soft 404-Fehler an." Das trifft regelmäßig leere Kategorie- und Suchergebnisseiten in Shops. Teuer wird es aus einem Grund, den Google klar benennt: „Seiten mit soft 404-Fehlern werden weiterhin gecrawlt und verschwenden damit dein Crawling-Budget."
Bei Nicht gefunden (404) lohnt ein Blick auf zwei Sätze, die viel Arbeit ersparen: „404-Antworten stellen nicht unbedingt ein Problem dar, wenn die Seite ersatzlos entfernt wurde" und „Es gibt keine Möglichkeit, den Googlebot anzuweisen, eine URL dauerhaft zu ignorieren. Der Googlebot crawlt die URL jedoch immer seltener." Der Bericht zeigt dabei ohnehin nur URLs, „bei denen im letzten Monat 404-Fehler aufgetreten sind".
URL-Prüfung: die Standardansicht ist kein Live-Test, und das ändert alles
Merkt euch, dass die Ansicht, die ihr zuerst seht, aus dem Archiv kommt. Google stellt das im URL-Prüftool ausdrücklich klar: „Dies ist kein Live-Test. Die angezeigten Ergebnisse stammen von der zuletzt indexierten Version einer Seite, nicht der Live-Version im Web." Wer gerade etwas repariert hat und danach in der Standardansicht nachsieht, prüft den Zustand von vorgestern.
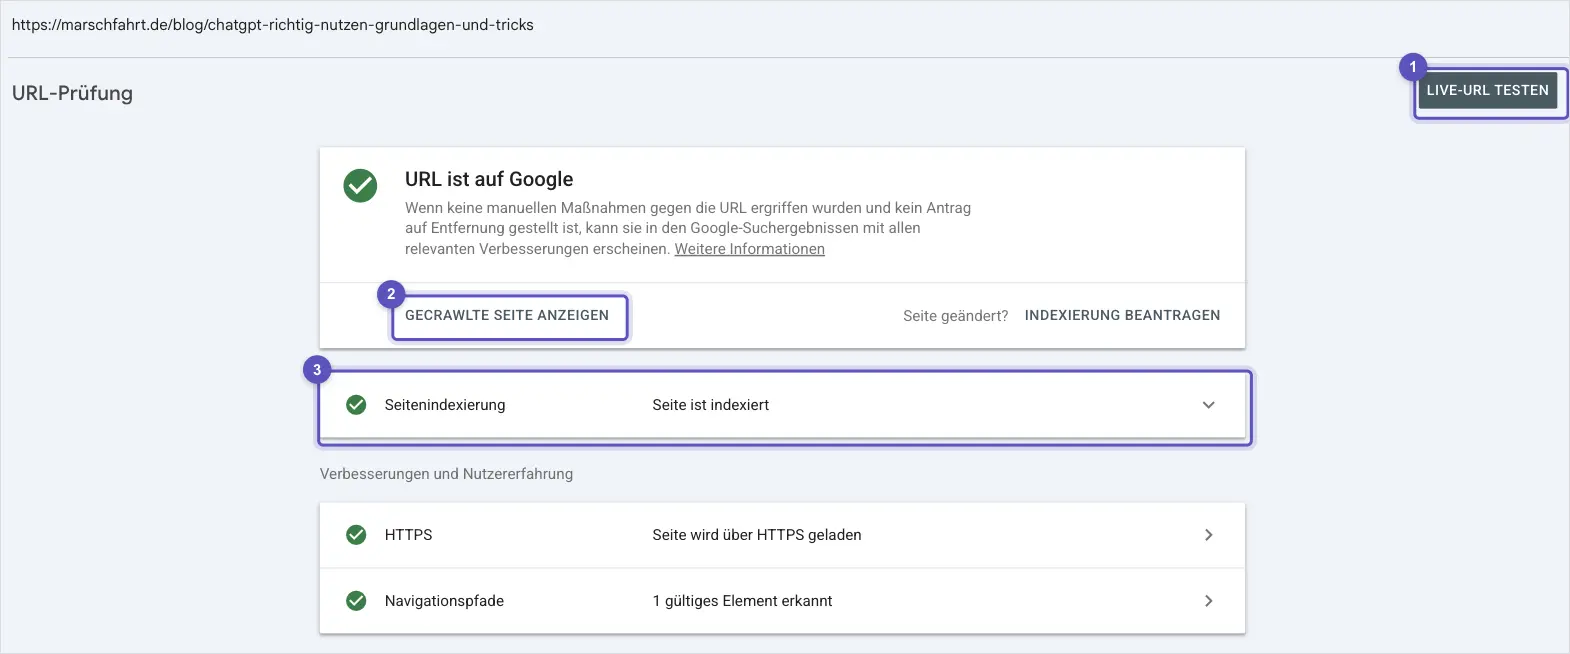
Die URL-Prüfung zeigt zuerst die indexierte Fassung. Den Live-Test startet ihr oben rechts (1). Gecrawlte Seite anzeigen (2) zeigt, was Google gespeichert hat, und aufgeklappt nennt Seitenindexierung (3) die kanonische URL, die Google gewählt hat.
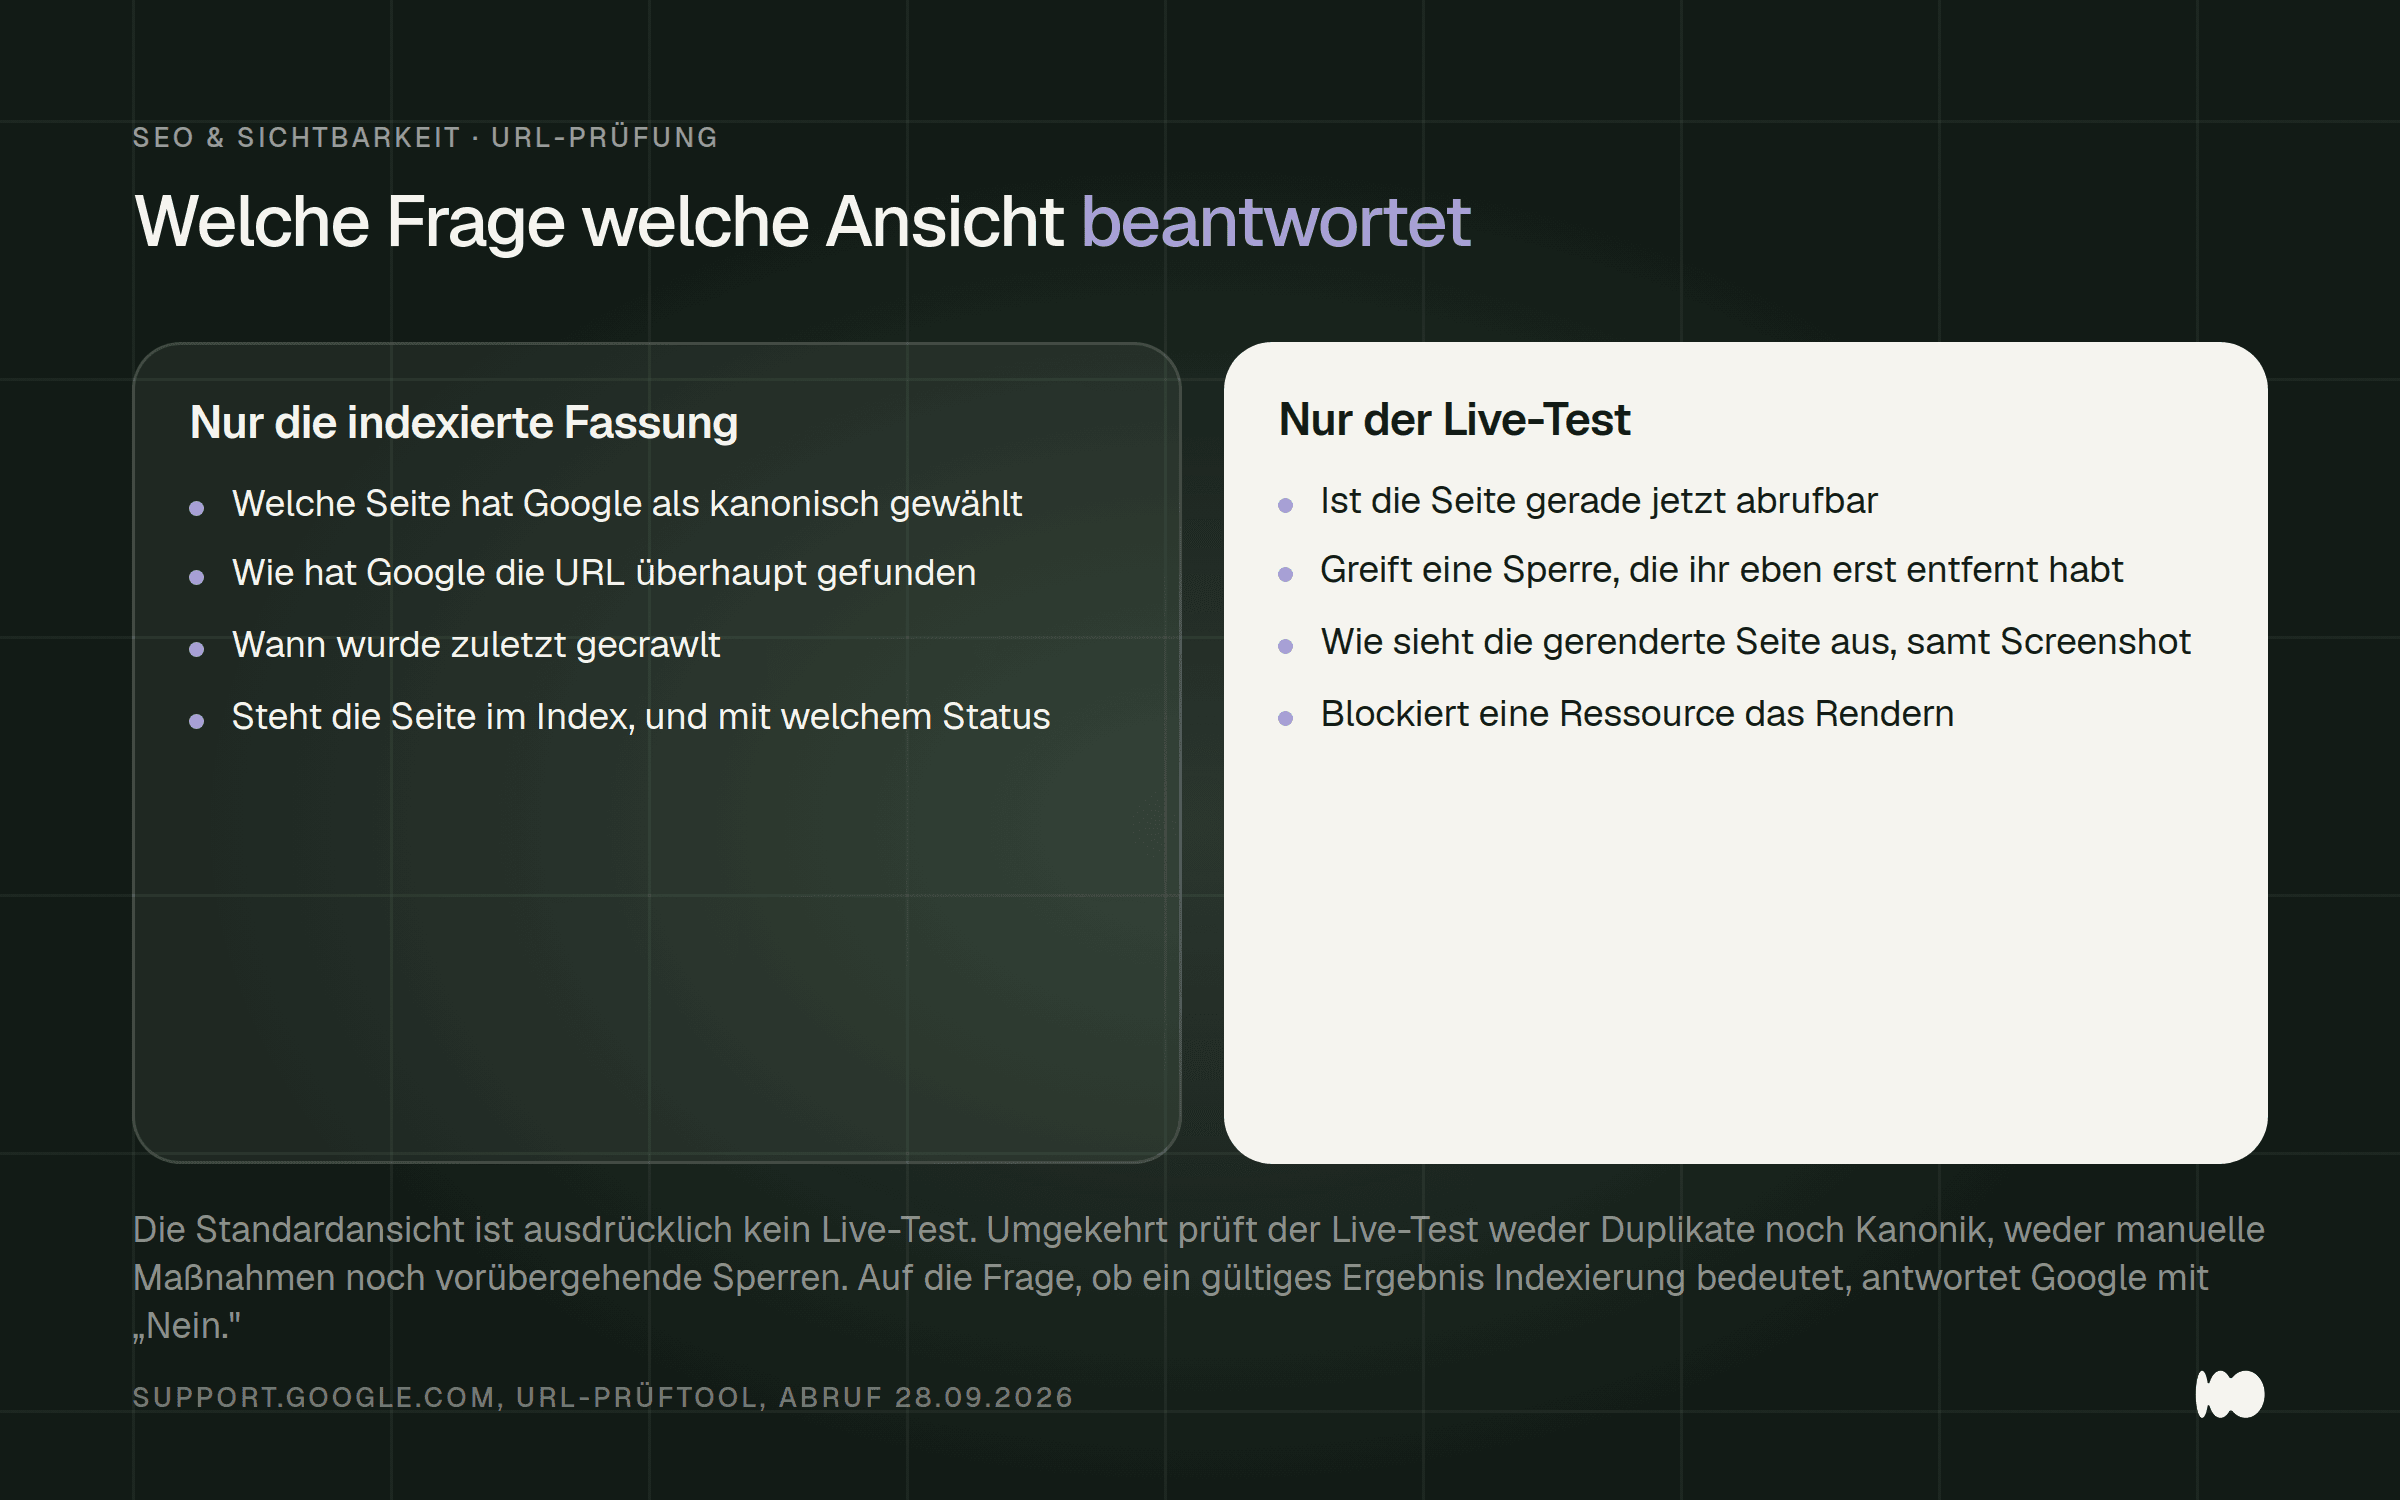
Was die indexierte Fassung zeigt und was der Live-Test kann, mit den Fragen, die jeweils nur die andere Ansicht beantwortet.
Umgekehrt kann der Live-Test weniger, als sein grünes Ergebnis verspricht. Google listet selbst auf, was er nicht prüft: Qualitäts- und Sicherheitsrichtlinien, manuelle Maßnahmen, rechtlich veranlasste Entfernungen und vorübergehende Sperren. Dazu kommt der Satz, der die meisten Fehldeutungen auflöst: „Beim Live-Test wird nicht auf alle möglichen Indexierungsprobleme getestet, etwa darauf, ob dies eine duplizierte oder alternative Seite ist."
Daraus folgt ein Handgriff, den ihr euch merken solltet: Die von Google gewählte kanonische Seite steht nur in der indexierten Fassung. Google schreibt: „Sie können die kanonische Version nur in den indexierten Daten ermitteln. Der Live-Test kann nicht vorhersagen, ob die getestete Version als kanonisch betrachtet wird." Wer wissen will, welche seiner drei ähnlichen Seiten Google für das Original hält, schaut also unter Indexierung nach, nicht im Live-Test.
Auf die naheliegendste Frage antwortet Google mit einem Wort. Auf „Bedeutet ein gültiges Ergebnis, dass meine Seite indexiert wird?" lautet die Antwort: „Nein." Genauso wenig ist der Status URL ist auf Google eine Zusage: „‚URL ist auf Google' heißt nicht, dass Ihre Seite in den Suchergebnissen erscheint."
Zum Knopf Indexierung beantragen gehören drei belegte Tatsachen. Er garantiert nichts: „Das Einreichen einer Anfrage garantiert nicht, dass die Seite im Google-Index erscheint." Er ist kontingentiert, wobei Google die Zahl nicht nennt, sondern nur: „Es gilt ein Limit für die Anzahl der Indexanfragen, die Sie pro Tag einreichen können." Und bei vielen Seiten ist er das falsche Werkzeug, denn Google verweist dafür auf die Sitemap mit dem Tag lastmod.
Sitemaps und das Entfernen-Werkzeug: zwei Werkzeuge, zwei verbreitete Irrtümer
Eine Sitemap ist ein Hinweis, keine Anmeldung. Google sagt das an drei Stellen, am klarsten so: „Beachte, dass das Einreichen einer Sitemap nur ein Hinweis ist: Es ist nicht garantiert, dass Google die Sitemap herunterlädt oder die Sitemap zum Crawlen von URLs auf der Website verwendet." Und für kleine Websites relativiert Google den Nutzen gleich mit: Unter „klein" versteht Google „eine Website mit ca. 500 oder weniger Seiten", bei der gute interne Verlinkung genügt.
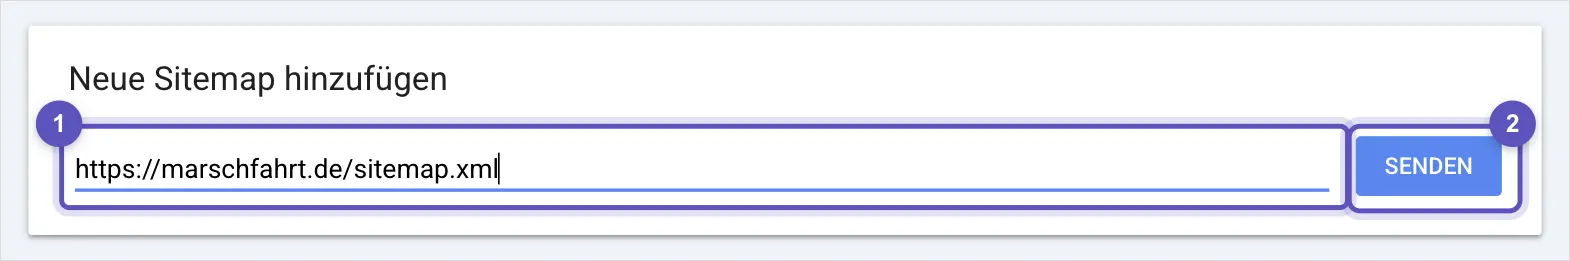
Eingereicht wird unter Indexierung › Sitemaps: Bei einer Domain-Property die vollständige Adresse der Sitemap eintragen (1), dann Senden (2).
Die harten Grenzen für den Fall, dass ihr doch eine braucht: „Bei allen Formaten gilt für eine einzelne Sitemap eine Obergrenze von 50 MB (unkomprimiert) oder 50.000 URLs." Die Datei muss UTF-8 sein, die URLs müssen absolut sein, und die Reihenfolge ist Google egal. Ein Fehler, der oft lange unbemerkt bleibt, heißt URL nicht zulässig und entsteht, wenn URLs auf einer höheren Ebene oder einer anderen Variante liegen als die Sitemap selbst; Protokoll und www zählen dabei mit.
Zwei Eigenheiten des Berichts sollte man kennen. Er zeigt nur, was ihr selbst eingereicht habt: „Sitemaps, die über eine robots.txt-Referenz oder andere Erkennungsmethoden gefunden wurden, werden hier nicht aufgeführt." Und Löschen wirkt nur im Bericht: „Wenn Sie eine Sitemap löschen, wird sie zwar aus diesem Bericht entfernt, aber Google vergisst die Sitemap und die darin aufgeführten URLs nicht."
Beim Entfernen-Werkzeug ist der Irrtum noch folgenreicher. Das Tool zum Entfernen und für SafeSearch-Meldungen entfernt nichts dauerhaft: „Ein erfolgreicher Ausschluss gilt nur für ca. sechs Monate." Es verhindert auch kein Crawling: „Wenn Sie eine URL ausschließen, wird dadurch nicht verhindert, dass die Seite gecrawlt wird. Sie erscheint nur nicht mehr in den Suchergebnissen."
Daraus folgt die Reihenfolge, die man leicht falsch macht. Wer die Seite gleichzeitig löscht, hebt den Ausschluss auf: Liefert die URL beim Antrag 404, 502 oder 503, geht Google davon aus, dass die Seite nicht mehr existiert, und „der Ausschluss läuft ab". Für dauerhaft gilt laut Google eines von drei Dingen: Inhalt weg mit 404 oder 410, Passwortschutz, oder noindex. Dazu die ausdrückliche Warnung: „Verwenden Sie keine robots.txt, um Seiten zu blockieren."
Core Web Vitals: warum der Bericht nie zu PageSpeed Insights passt
Vergleicht die beiden Werkzeuge gar nicht erst, sie messen verschiedene Dinge. Die Zahlen in der Search Console stammen laut Google „aus dem CrUX-Bericht", und dazu heißt es: „Darin werden anonymisierte Messwerte zur Seitenleistung von tatsächlichen Nutzern erfasst, die Ihre URL aufrufen." Das sind Felddaten. PageSpeed Insights zeigt daneben einen Labortest, und der misst eine einzelne, künstliche Ladung.
Die Schwellenwerte sind eindeutig und lohnen sich zum Merken: LCP bis 2,5 Sekunden gilt als gut, ab 4 Sekunden als schlecht. INP bis 200 Millisekunden ist gut, ab 500 schlecht. CLS bis 0,1 ist gut, ab 0,25 schlecht. Maßstab ist dabei nicht der Durchschnitt, sondern das 75. Perzentil: Der Status gilt, wenn drei Viertel der Aufrufe ihn erreichen.
Der entscheidende Unterschied ist aber die Gruppierung. Die Search Console fasst URLs zu Gruppen mit ähnlicher Nutzererfahrung zusammen, und der Status „gilt für die gesamte Gruppe". Google nennt die Annahme dahinter selbst: Diese Gruppen hätten „ein gemeinsames Framework", die Ursachen seien deshalb wahrscheinlich dieselben. PageSpeed Insights zeigt dagegen einzelne URLs, und eine davon kann in ihrer Gruppe ein Ausreißer sein.
Dazu kommt eine Kleinigkeit mit großer Wirkung: Die Search Console behandelt URLs mit Parametern als eigene Adressen, PageSpeed Insights wirft Parameter weg und rechnet alles auf die nackte URL. Wer also einen Shop mit Filter-URLs betreibt, bekommt zwangsläufig zwei verschiedene Bilder.
Google zieht die Konsequenz selbst: „Es ist nicht die primäre Aufgabe dieses Berichts, Aussagen über den Status einzelner URLs zu treffen." Nehmt den Bericht also, um Muster über viele Seiten zu finden, und ein externes Werkzeug, um eine einzelne Seite zu untersuchen. Zwei Eigenheiten noch, die Fehldeutungen erklären: Die Daten aller Länder werden zusammengeworfen, und anders als in den meisten Berichten werden sie „der tatsächlichen URL zugeordnet, nicht der kanonischen URL". Wie groß die Unterschiede zwischen Systemen dabei ausfallen, haben wir an 736 Websites gemessen.
Die neuen Berichte für KI-Antworten: was sie zeigen und was nicht
Seit dem 31. August 2026 könnt ihr eure Sichtbarkeit in KI-Antworten getrennt auswerten, aber nur als Impressionen. Google hat den Leistungsbericht für generative KI-Funktionen an diesem Tag „für alle Websites weltweit" freigeschaltet. Er umfasst zwei Funktionen, die Google als Übersichten mit KI und KI-Modus bezeichnet.
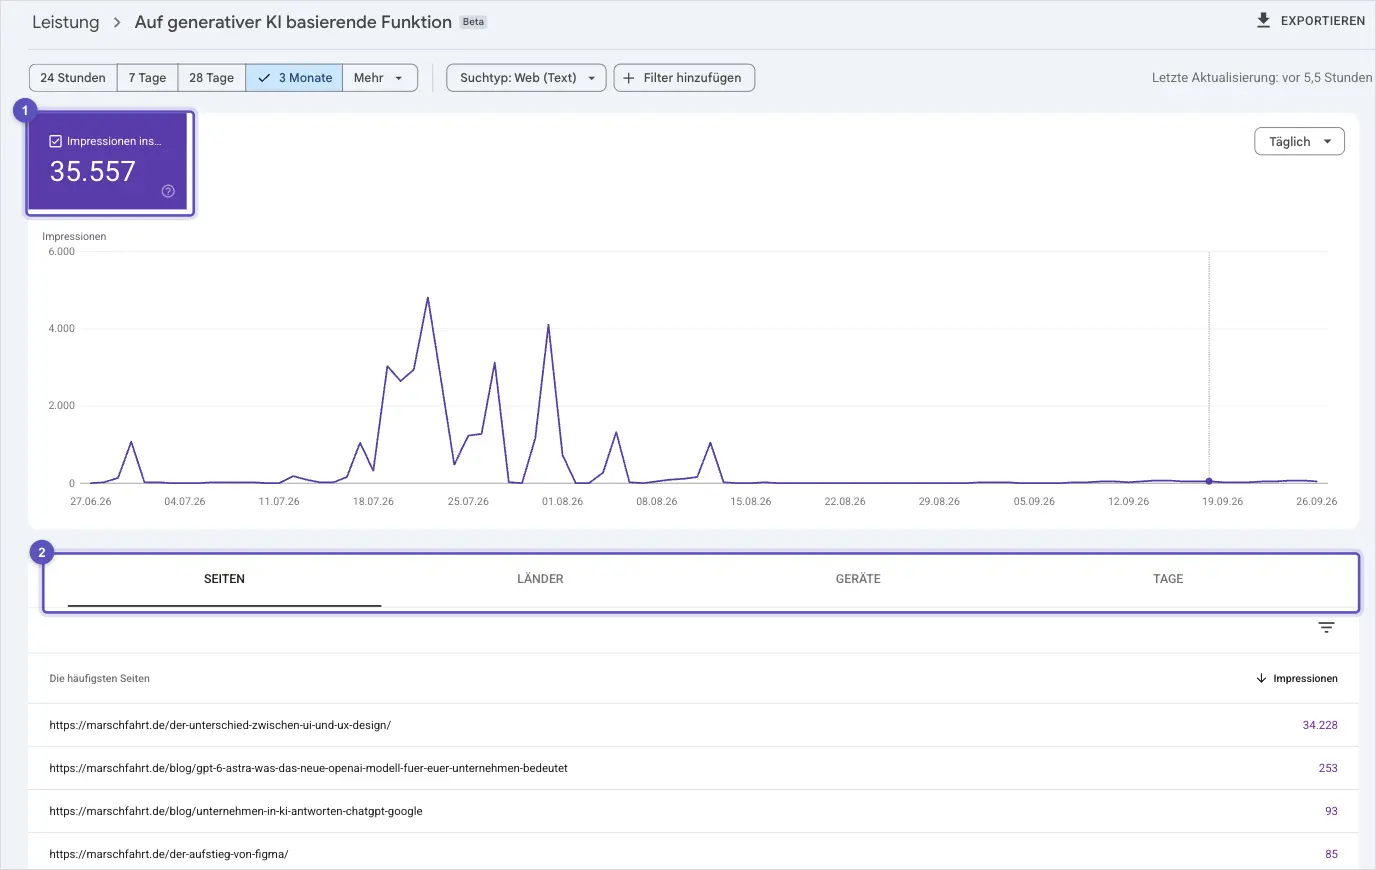
Der neue Bericht unter Leistung › Generative KI, hier für unsere Website. Es gibt nur eine Kachel, Impressionen (1), und die Tabs (2) heißen Seiten, Länder, Geräte und Tage. Einen Tab für Suchanfragen gibt es nicht.
Die wichtigste Einschränkung steht in derselben Dokumentation: Es gibt dort ausschließlich Impressionen, keine Klicks, keine Klickrate, keine Position. Wer also wissen will, ob KI-Antworten ihm Besucher bringen, bekommt darauf keine Antwort, sondern nur die Auskunft, wie oft er dort überhaupt aufgetaucht ist. Auch die üblichen Grenzen gelten weiter, ausdrücklich „1.000 Zeilen, Zeitraum".
Für die Einordnung hilft eine Regel aus dem normalen Leistungsbericht: Eine Übersicht mit KI „belegt eine einzelne Position in den Suchergebnissen", und ein Klick auf einen Link darin „zählt als Klick". KI-Antworten sind in eurer normalen Kurve also längst enthalten, der neue Bericht trennt sie nur heraus.
Rechte und Tokens: warum das Entziehen beim Agenturwechsel nicht reicht
Wer einer alten Agentur nur die Rechte entzieht, hat sie nicht ausgesperrt. Das ist die unangenehmste Stelle im ganzen Werkzeug, und Google schreibt sie offen hin: „Wenn Sie einen Inhaber aus einer Search Console-Property entfernen, kann er nicht mehr auf die Property zugreifen, seine Bestätigungstokens werden jedoch weder gelöscht noch widerrufen." Im Klartext: Die Datei auf eurem Server oder das Tag im Quelltext liegt weiter da, und damit kann sich derjenige jederzeit neu bestätigen.
Aufgeräumt wird an einer Stelle, die man kennen muss, weil sie niemand von allein findet: Einstellungen, dann Nutzer und Berechtigungen, dort der Bereich Nicht verwendete Inhabertokens. Je nach Methode müsst ihr zusätzlich die hochgeladene HTML-Datei löschen, das Meta-Tag aus dem Quelltext nehmen oder den DNS-Eintrag entfernen.
Dabei gilt eine Warnung von Google, die eine teure Panne verhindert: „Seien Sie vorsichtig, wenn Sie Tokens entfernen. Dasselbe Bestätigungstoken kann für verschiedene Dienste zur Bestätigung der Inhaberschaft verwendet werden." Wer also das Token löscht, kann damit versehentlich die Bestätigung im Merchant Center oder in Google Workspace mit abräumen. Erst nachsehen, dann löschen.
Zwei Funktionen helfen beim Aufräumen und bei der Frage, wer da eigentlich alles Zugriff hat. Der Inhaberschaftsverlauf zeigt hinzugefügte und entfernte Inhaber samt erfolgreichen und gescheiterten Bestätigungsversuchen. Und wenn sich ein früher entfernter Inhaber neu bestätigt, „werden alle aktuellen Inhaber benachrichtigt". Diese Mail sollte bei euch landen und nicht im Postfach eines ehemaligen Dienstleisters.
Für den Alltag reicht die Rollenwahl: Ein Uneingeschränkter Nutzer sieht alle Daten und darf bestimmte Maßnahmen ergreifen, ein Eingeschränkter Nutzer sieht die meisten Daten. Beides lässt sich jederzeit wieder entziehen, und die Änderung „wird normalerweise umgehend wirksam". Genau deshalb gehört eine Agentur auf diese Stufe und nicht auf Inhaber. Eine Property fasst übrigens bis zu 100 Nutzer, die keine Inhaber sind.
Sechs Handgriffe, die kaum jemand macht
Erstens: Schaltet für den Tag eines Relaunchs auf die 24-Stunden-Ansicht. Sie „enthält Daten aus den letzten verfügbaren 24 Stunden und wird mit einer Verzögerung von nur wenigen Stunden angezeigt", während die normale Ansicht Tage braucht. Wer zusätzlich den angefangenen heutigen Tag sehen will, schaltet in der Datumsauswahl die Option für vollständige Tage ab.
Zweitens: Vergleicht, statt zu filtern. Im Filterdialog gibt es die Option Vergleichen, und die Ergebnistabelle bekommt dann eine Spalte Differenz. Google rät beim Zeitraumvergleich ausdrücklich zu „Wöchentlich" oder „Monatlich", weil Tageswerte zu unruhig sind. Achtung: Es lässt sich immer nur ein Vergleich anzeigen, ein neuer überschreibt den alten.
Drittens: Gebt den Bericht per Link weiter, statt Zugriff zu vergeben. Über die Schaltfläche Teilen bekommt der Empfänger genau die aktuelle Ansicht zu sehen, sonst nichts. Für den Steuerberater, den Beirat oder den Kunden ist das der richtige Weg, und niemand muss dafür Nutzer werden.
Viertens: Werft einen Blick in die Crawling-Statistik, besonders auf den Hoststatus. Der Bericht sitzt versteckt unter den Property-Einstellungen und richtet sich laut Google „an fortgeschrittene Nutzer". Für Websites unter 1.000 Seiten braucht ihr ihn selten, aber die drei Zeilen robots.txt-Abruf, DNS-Auflösung und Serververbindung lohnen immer einen Blick.
Der Grund steht in einem Satz, der jede Diskussion über Indexierungsprobleme abkürzt: „Wenn Ihre robots.txt-Datei für einen Tag nicht verfügbar ist, unterbricht Google das Crawling." In den ersten zwölf Stunden wird gar nicht gecrawlt, danach arbeitet Google bis zum dreißigsten Tag mit der zuletzt erfolgreich abgerufenen Fassung. Eine Wartungsphase, in der die Datei einen Fehler liefert, kostet euch also Crawling, ohne dass es irgendwo sonst auffällt.
Fünftens: Tragt die Sitemap zusätzlich in die robots.txt ein. Google schreibt dazu: „In diesem Bericht werden nur Sitemaps angezeigt, die Sie über diesen Bericht oder die API eingereicht haben." Der Bericht findet also die per robots.txt bekannt gemachten nicht. Umgekehrt braucht der Weg über die robots.txt keine Inhaberrechte, und für viele Kunden ist das der einzige Weg, den ihre Agentur nicht blockieren kann.
Sechstens: Nehmt bei vielen aktualisierten Seiten die Sitemap statt den Knopf. Google sagt es selbst: „Wenn Sie die Indexierung vieler neuer oder aktualisierter Seiten anfordern möchten, sollten Sie eine Sitemap einreichen, in der die aktualisierten Seiten mit lastmod gekennzeichnet sind." Das ist der Unterschied zwischen einer Stunde Klickarbeit und zwei Minuten am Generator.
Und noch eine Kleinigkeit für alle, die exportieren: Werte, die im Bericht als Tilde oder Bindestrich erscheinen, stehen in der heruntergeladenen Datei als Nullen. Wer in der Tabellenkalkulation Durchschnitte bildet, rechnet sonst mit Nullen, die in Wirklichkeit fehlende Werte sind.
Fazit: was heute, was diese Woche, was später
Heute prüft ihr eine einzige Sache: ob eure Property die ganze Website abdeckt. Steht dort eine URL mit http, oder fehlt eine Subdomain, dann arbeitet ihr seit Jahren mit einem Ausschnitt. Der DNS-Eintrag für die Domain-Property ist in zehn Minuten gesetzt und bringt mehr als jede Auswertung, die ihr auf der alten Datenbasis macht.
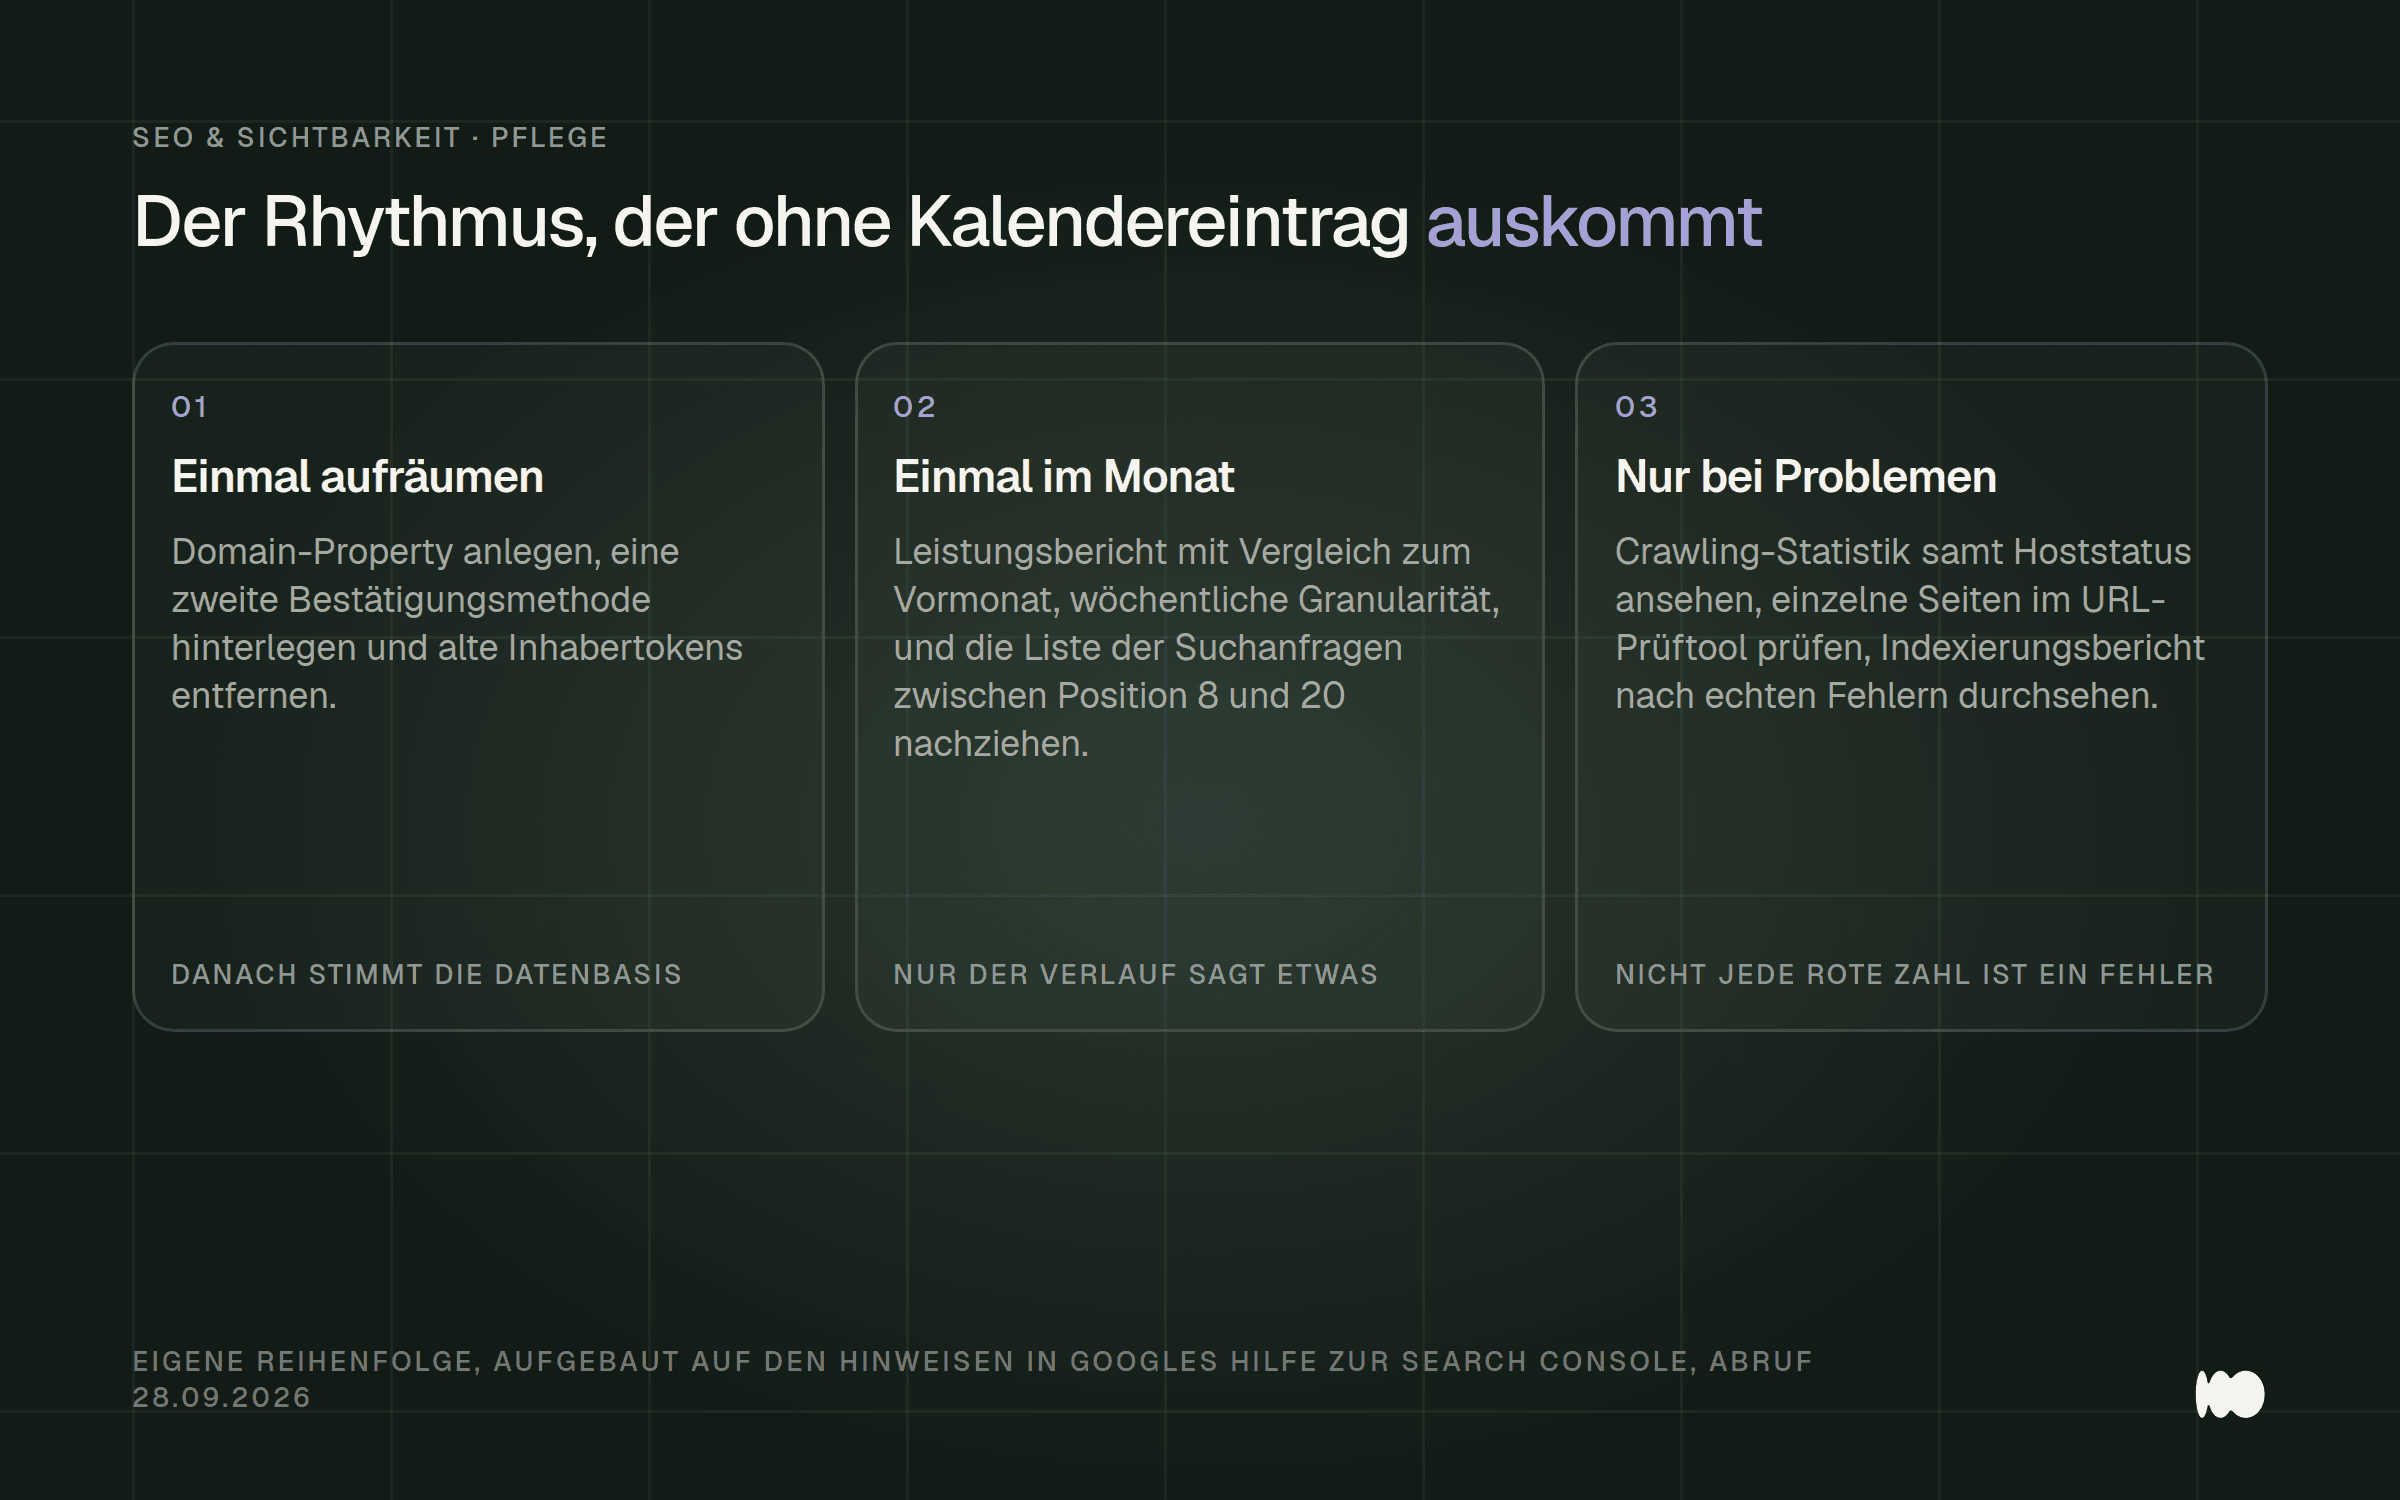
Ein Rhythmus, der ohne Kalendereintrag auskommt: einmal aufräumen, einmal im Monat auswerten, und ein Blick, der nur bei Problemen fällig wird.
Diese Woche nehmt ihr euch die drei Auswertungen vor, die etwas ergeben: die Liste der Suchanfragen zwischen Position 8 und 20, die Prüfung auf zwei eigene Seiten zur selben Suchanfrage, und einen Durchgang durch die Statusgründe im Indexierungsbericht, bei dem ihr alles stehen lasst, was Google ausdrücklich als unproblematisch bezeichnet.
Später, und zwar dauerhaft, reichen drei Gewohnheiten. Einmal im Monat der Leistungsbericht mit Vergleich zum Vormonat, weil nur der Verlauf etwas aussagt. Bei jedem Relaunch eine Anmerkung direkt ins Diagramm. Und beim Wechsel eines Dienstleisters die Tokens aufräumen, nicht nur die Rechte entziehen.
Was wir uns im Studio abgewöhnt haben: aus einzelnen Wochen Schlüsse zu ziehen. Google schreibt selbst, es sei schwierig festzustellen, ob eine bestimmte Änderung direkt zu einer besseren Suchleistung geführt habe. Wer eine Seite überarbeitet und drei Tage später auf die Kurve schaut, sieht Rauschen und hält es für ein Ergebnis.
Was sich geändert hat und was das für euch heißt
31. August 2026: Die Berichte für generative KI-Funktionen gelten weltweit für alle Websites. Für euch heißt das: Ihr könnt endlich nachsehen, wie oft ihr in Übersichten mit KI und im KI-Modus auftaucht, statt es zu schätzen. Erwartet aber keine Klickzahlen, es gibt dort nur Impressionen.
29. Juli 2026: Plattform-Properties sind weltweit verfügbar. Instagram, TikTok, X und YouTube lassen sich als eigener Property-Typ anlegen, ausdrücklich auch von Leuten „ohne eigene Website". Für euch heißt das: Wenn ein Teil eurer Sichtbarkeit über Social-Kanäle läuft, ist das jetzt messbar, ohne Fremdwerkzeug.
11. März 2026: Der Filter für Marken-Suchanfragen steht allen geeigneten Websites offen. Für euch heißt das: Die Trennung zwischen Suchen nach eurem Namen und echten Neukundensuchen geht ohne Regex-Liste. Achtet nur darauf, dass sie nur auf oberster Property-Ebene funktioniert und dass Google selbst Fehlzuordnungen einräumt.
17. November 2025: Eigene Anmerkungen lassen sich direkt ins Diagramm setzen. Rechtsklick auf die Kurve, Datum und bis zu 120 Zeichen. Für euch heißt das: Relaunch, Systemwechsel oder Betriebsurlaub stehen dort, wo man sie ein halbes Jahr später sucht. Denkt daran, dass jeder mit Zugriff auf die Property sie lesen kann.
1. Oktober 2025: Veraltete Felder im Bulk-Export nach BigQuery liefern NULL statt FALSE. Für euch heißt das nur etwas, wenn ihr diesen Export nutzt, dann aber viel: Abfragen mit NOT is_typ rechnen seitdem still falsch. Google empfiehlt stattdessen is_typ IS NOT TRUE.
30. Juni 2025: Der Statistikbericht ist fest in die Search Console eingezogen. Für euch heißt das: Die frühere eigenständige Beta gibt es nicht mehr, dafür steht der Bericht jetzt neben den anderen und gruppiert ähnliche Suchanfragen, was bei vielen Longtail-Anfragen übersichtlicher ist als die rohe Liste.
Stand dieser Fassung: 29. September 2026.
Wollt ihr wissen, was in eurer Search Console gerade übersehen wird?
Schreibt uns, wir schauen einmal hinein und sagen euch, welche drei Handgriffe bei euch am meisten bringen. Meistens sind es dieselben drei: eine Property, die nur die halbe Website abdeckt, ein Stapel Seiten mit einem Indexierungsstatus, den niemand gelesen hat, und ein Dutzend Suchanfragen knapp vor der ersten Ergebnisseite, die seit Monaten dort festsitzen.
Eine kurze Nachricht über unser Kontaktformular genügt, eure Domain reicht uns als Einstieg. Wir antworten innerhalb von 24 Stunden, persönlich und ohne Vertriebsgespräch.
Weitere Artikel
© Marschfahrt Studio
Praxiswissen rund um Webdesign, SEO, KI und Conversion-Optimierung. Aus echten Projekten, ohne Marketing-Filter.

